Já tem uma conta?
Faça o seu loginNão tem uma conta?
Preencha o formulário abaixo para efetuar seu cadastro.
Em caso de não possuir CPF, por favor entre em contato conosco clicando aqui.
Live ainda não está liberada para assistir, aguarde na página até que o botão de assistir seja liberado!
Desvende a Governança de IA e os Marcos Legais para uma Inteligência Artificial Segura
01/08/2025 às 10:00 (GMT-3)
Palestrantes
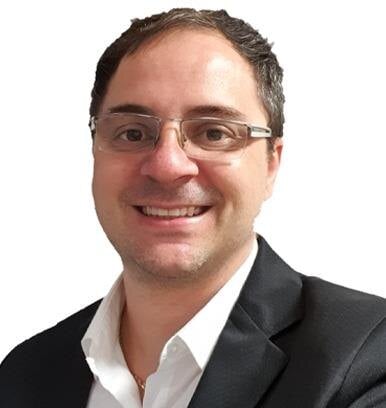
Alex Gonçalves Rabello
Declaração
De participação
Avaliações
Nenhum voto até agora! Seja o primeiro a avaliar este post.
0
/5
Avaliação média
0
Nº de votos
A inteligência artificial já é uma realidade em setores como saúde, educação, finanças e governo, entre outros. Porém, sem diretrizes de ética de governança claramente definidas, seu uso corre o risco de desigualdade e viés, falta de transparência e infringimento de direitos fundamentais.
Ciente disso, a Escola Superior de Redes criou o curso a distância “Governança de IA para Todos” para ajudar os participantes a aprenderem os princípios e práticas regulatórias que são essenciais para criar e implementar IA que é tão segura quanto socialmente responsável.
Neste webinar de 1 hora, resumiremos os pontos do curso e argumentaremos do porquê a governança de IA é necessária.
Exploraremos os princípios fundamentais por trás da IA e suas aplicações, discutiremos a importância de princípios éticos em IA Responsável e passaremos pelos marcos regulatórios do Brasil, em especial, a Lei Geral de Proteção de Dados, bem como o PL 2338/2023.
Além disso, apresentaremos exemplos reais de casos.
Este webinar é adequado para profissionais de TI, advogados, funcionários públicos e executivos, estudantes e qualquer pessoa que esteja interessada em ajudar a criar um ambiente de IA seguro e justo.
Junte-se a nós e descubra como criar uma IA alinhada com a sociedade e às melhores práticas!
Alex Gonçalves Rabello
Com mais de duas décadas de experiência em Governança de dados e Segurança da informação, Alex Rabello atua desde agosto de 2023 como gerente de Privacidade dos Dados e Governança de IA nos Estados Unidos, liderando projetos de adequação de privacidade e governança de dados. Membro ativo da Comissão de Segurança da Informação, Cibersegurança e Proteção de Privacidade da ABNT desde 2020, ele contribui para a elaboração de normas internacionais de segurança e conformidade. . Paralelamente, ministra cursos de LGPD e GDPR em instituições como IESB, ESR e Ibmec, formando profissionais em governança de dados e compliance. . Sua trajetória combina prática empresarial e academia, tornando-o referência em privacidade, segurança da informação e governança de IA.
Webinars Relacionados
-
Próximos eventos
IA sem governança é risco
Descrição
A inteligência artificial está transformando serviços e decisões. Mas como aproveitar seu potencial sem ignorar os riscos éticos, regulatórios e organizacionais? Neste webinar você conhecerá os fundamentos da Governança de IA e entenderá como princípios, práticas e mecanismos de controle contribuem para uma adoção mais segura, ética e responsável dessas tecnologias. O que você vai aprender: – Fundamentos de IA: conceitos de inteligência artificial, aprendizado de máquina e sistemas de IA. – Governança de IA: princípios fundamentais e sua relação com a governança organizacional. – Ética e responsabilidade: transparência, vieses e riscos de discriminação. – Regulação e frameworks: visão geral dos marcos regulatórios brasileiros e das estruturas de referência para governança de IA. – Gestão de riscos: identificação de riscos associados ao uso da IA e práticas básicas para sua mitigação. Ao final, você terá uma visão geral dos principais elementos da Governança de IA e estará mais preparado para reconhecer riscos, orientar decisões e contribuir para o uso responsável da inteligência artificial em organizações e projetos.30/10/2026
10:00
*É necessário estar logado(a) para assistir.
-
Próximos eventos
Arquiteturas Avançadas de Segurança com FortiGate
Descrição
O treinamento Arquiteturas Avançadas de Segurança com FortiGate (NUV-13) capacita profissionais a projetar, implementar e administrar ambientes de rede seguros utilizando recursos avançados da plataforma Fortinet. O curso aborda temas como segmentação de rede, VPNs, políticas de segurança, IPS, controle de aplicações, filtragem web, alta disponibilidade (HA), monitoramento e troubleshooting, com foco na proteção, disponibilidade e desempenho da infraestrutura corporativa. Objetivo: desenvolver habilidades para construir arquiteturas de segurança robustas e resilientes, aplicando as melhores práticas de proteção e gestão de redes corporativas.06/11/2026
10:00
*É necessário estar logado(a) para assistir.
-
Webinars 2026 Finalizados
IA Aplicada ao Gerenciamento de Projetos
Descrição
Dar um panorama das aplicações práticas de IA para gerenciamento de projetos, principalmente em consolidar informações, planejar projetos, apontar tendências, gerar riscos e possíveis respostas e produzir reportes executivos, sempre considerando a validação humana, a qualidade dos dados, a segurança das informações e as boas práticas de gestão. -
Webinars 2026 Finalizados
Educação e Habilidades na Era da Inteligência Artificial
Descrição
A transformação digital impulsionada pela Inteligência Artificial trouxe novas oportunidades para o Brasil, governos, empresas e instituições de ensino. E elevou a relevância de temas como ética, proteção de dados, governança, infraestrutura, desenvolvimento de capacidades nacionais e novas habilidades para o futuro do trabalho. Nesta sessão, serão compartilhados soluções, experiências e aprendizados da iniciativa desenvolvida com a ESR para apoiar estratégias de modernização tecnológica e adoção responsável de Inteligência Artificial na Educação. A apresentação também abordará o papel da Microsoft Elevate e ESR no fortalecimento da educação pública, destacando projetos realizados no Brasil para ampliar o acesso a competências digitais, IA, formação de professores e inclusão tecnológica em larga escala. -
Webinars 2026 Finalizados
Você é o alvo: o que todo profissional precisa saber sobre segurança da informação
Descrição
Você é o alvo: o que todo profissional precisa saber sobre segurança da informação Um clique em um e-mail falso, uma senha fraca ou um arquivo compartilhado sem cuidado podem colocar em risco os dados de uma organização inteira. Este webinar mostra, de forma simples e prática, por que a segurança da informação não é assunto apenas da equipe de tecnologia, mas uma responsabilidade de todos que lidam com dados e sistemas no dia a dia. O encontro é voltado para profissionais do setor público, dos três poderes, e da iniciativa privada, de qualquer área de formação. Interessa especialmente a quem trabalha com informações sensíveis ou dados pessoais, a gestores que respondem por equipes e processos e a quem deseja começar uma carreira em uma área que precisa cada vez mais de profissionais qualificados. Durante o webinar, vamos conversar sobre: o que é segurança da informação e quais são seus pilares: confidencialidade, integridade e disponibilidade; os golpes e ataques mais comuns hoje, como phishing, engenharia social e ransomware, com exemplos reais de casos no Brasil; como reconhecer uma mensagem fraudulenta, a partir da análise de um exemplo real; como a criptografia protege o que fazemos na internet, dos sites seguros aos certificados digitais; o que a LGPD exige na proteção de dados pessoais; o que fazer quando algo dá errado e acontece um incidente de segurança; por que gestão de riscos e conscientização são essenciais para proteger qualquer organização. Ao final, apresentaremos o curso Fundamentos de Segurança da Informação, oferecido em parceria oficial com a Ascend. Com nove módulos e laboratórios práticos, o curso aprofunda esses temas e vai além, incluindo segurança de redes e nuvem, identificação de vulnerabilidades, monitoramento, controle de acesso e resposta a incidentes. -
Webinars 2026 Finalizados
Docker: falha do usuário root, capabilities e modo privileged
Descrição
Muito se comenta sobre o uso do usuário “root” dentro de um container. Mas você sabe de fato o porquê disso? Na prática, com uso de Capabilities e o modo Privileged do Docker, será exposto precisamente o que você precisa saber para melhor proteger o seu container. Tópicos abordados: – Falha do usuário root ao montar bind volumes – Capabilities – Modo privileged – Dica: o canivete suíço para containers
Cursos relacionados
-
OnlineEducação Corporativa
Feedback Lideranças – Conversas que orientam
Aprimore suas habilidades de liderança com técnicas para conduzir conversas de feedback claras, estruturadas e orientadas ao desenvolvimento. Aprenda a abordar comportamentos, lidar com reações desafiadoras e estabelecer próximos passos que fortaleçam o desempenho das equipes.Nível: Básico
Gratuito!
4horas -
OnlineEducação Corporativa
Cultura do Feedback – O Feedback começa em mim
Desenvolva sua capacidade de dar e receber feedback de forma clara, respeitosa e construtiva. Aprenda técnicas para conduzir conversas desafiadoras, fortalecer relações profissionais e promover uma cultura de aprendizagem e desenvolvimento contínuo.Nível: Básico
Gratuito!
2horas -
OnlineGovernança de TI
Gerenciamento de Serviços de TI
Eleve a gestão de serviços de TI com práticas reconhecidas para otimizar processos, reduzir desperdícios e gerar mais valor para o negócio.Nível: Intermediário
Gratuito!
32horas -
PresencialGovernança de TI
Gerenciamento de Serviços de TI
Eleve a gestão de serviços de TI com práticas reconhecidas para otimizar processos, reduzir desperdícios e gerar mais valor para o negócio.Nível: Intermediário
Gratuito!
32horas -
OnlineEducação Corporativa
Capacitação Executiva em Propriedade Intelectual e Transferência de Tecnologia na RNP
Proteja, valorize e transforme ativos intelectuais em oportunidades estratégicas para inovação, parcerias e geração de valor na RNP.Nível: Básico
Gratuito!
11horas -
OnlineEducação Corporativa
Multiplicadores Internos
Transforme conhecimento em aprendizagem: comunique com clareza, engaje pessoas e multiplique resultados na sua organização.Nível: Básico
Gratuito!
4horas
posts recentes
-
 Computação em NuvemNa rotina das equipes de suporte e infraestrutura de TI, determinados chamados acendem alertas imediatos: colaboradores impedidos de emitir notas fiscais, sistemas internos desconectados do banco de dados e clientes externos relatando erro ao carregar a plataforma de serviços. Esse comportamento, quando associado à presença de conectividade física, geralmente denuncia a ocorrência de falhas de DNS que paralisam a operação corporativa sem deixar pistas óbvias nos painéis convencionais. Diante do incidente, o fluxo padrão do time técnico costuma seguir o roteiro: abrem-se os consoles de monitoramento, examinam-se tabelas de roteamento, revisam-se regras de firewall e afere-se a ocupação de processamento e memória nos servidores. Os gráficos, contudo, indicam estabilidade. O circuito de rede responde sem perdas, a conectividade física permanece íntegra e, ainda assim, nenhuma estação de trabalho conclui a requisição. Essa aparente contradição ocorre porque o monitoramento tradicional tende a auditar apenas a saúde das aplicações ativas, ignorando que o tráfego depende intrinsecamente do sistema de nomes para existir. Antes que a camada de transporte consiga estabelecer uma conexão TCP ou concluir o handshake TLS, a máquina solicitante, por meio do stub resolver do sistema operacional, precisa traduzir o FQDN (Fully Qualified Domain Name) – o domínio alfanumérico – em um endereço IP. Se a cadeia de consultas sofrer uma interrupção em nós intermediários ou devolver um registro obsoleto, a conexão sequer chega a ser iniciada. O navegador exibe a tela de indisponibilidade, e o primeiro pacote de dados da aplicação nunca ultrapassa a interface local de rede. Dominar o processo de resolução DNS, com base em suas diretrizes normativas, permite abandonar métodos de tentativa e erro, entender em que parte a consulta foi interrompida e reduzir expressivamente o tempo médio de recuperação (MTTR) em incidentes críticos de infraestrutura. Os pontos de interrupção na cadeia de resolução: a origem das falhas de DNS O DNS funciona sob uma estrutura hierárquica e distribuída, regulamentada inicialmente pela RFC 1035 da IETF, atualizada e ampliada por RFCs complementares que garantem a adaptação do sistema aos requisitos modernos dos serviços disponíveis na internet Essa arquitetura depende de um equilíbrio sensível entre servidores autoritativos, responsáveis por uma zona de domínio, resolvedores recursivos e memórias de cache locais. Quando esse circuito sofre uma quebra em algum nó intermediário, os sintomas exibidos na tela induzem a diagnósticos incorretos: Sintoma observado no sistema Ponto real de falha na rede Norma técnica / Causa primária Timeout em chamadas de API Firewalls corporativos que descartam pacotes UDP superiores a 512 bytes Bloqueio indevido de extensões EDNS0 (RFC 6891) Erro de validação de certificados Servidores apontados no registrador não respondem pela zona Delegação inconsistente (Lame Delegation – RFC 8499) no TLD Banco de dados corporativo inacessível Cache local que grava erro temporário de domínio inexistente Retenção por Negative Caching (RFC 2308) Usuários presos a servidores antigos Ausência de redução preventiva do tempo de vida dos registros Parâmetro TTL descalibrado durante migrações A análise detalhada dessas variáveis revela como a infraestrutura de rede e os mecanismos de segurança afetam o comportamento da aplicação. No topo dessa lista de incidentes, o bloqueio de pacotes EDNS0 (RFC 6891) ilustra com precisão essa dependência. Consultas modernas utilizam extensões de protocolo para viabilizar mensagens UDP superiores ao limite histórico de 512 bytes, formato mandatório, por exemplo, para transportar dados de registros criptográficos e assinaturas de segurança, como aqueles envolvidos na implementação de DNSSEC. Contudo, equipamentos de borda configurados com regras restritivas ou inspeções defasadas descartam esses pacotes por interpretá-los como anomalias de rede. Como consequência direta, a requisição entra em ciclos sucessivos de timeout, provocando lentidão e travamentos intermitentes nos resolvedores recursivos corporativos. Além de falhas no tráfego de rede, a integridade do DNS depende estritamente da coerência da sua hierarquia. Uma das manifestações mais críticas de inconsistência cadastral é a delegação inconsistente (Lame Delegation) que provoca rupturas definitivas de comunicação. Esse incidente ocorre quando as configurações registradas na entidade de controle (como o Registro.br) apontam para servidores de nomes que não custodiam a zona do domínio ou quando inexistem os registros de amarração (Glue Records) com os endereços diretos desses servidores. Sem uma resposta válida do servidor delegado, a consulta falha e devolve o erro SERVFAIL para o usuário. Essa cadeia de dependências se torna ainda mais sensível com o mecanismo de persistência de respostas negativas (Negative Caching – RFC 2308). Quando uma estação consulta um registro recém-criado antes que ele termine de ser processado no servidor autoritativo, o sistema operacional armazena a resposta de erro (NXDOMAIN) pelo intervalo estipulado no campo de tempo mínimo do registro SOA, que armazena informações administrativas e de controle sobre uma zona de domínio. Mesmo que a equipe de engenharia de redes configure o apontamento correto instantes depois, a máquina continuará rejeitando a conexão até que o tempo do cache negativo expire integralmente. Em contexto similar, o TTL descalibrado mantém no cache do cliente ou do resolvedor um registro desatualizado que, apesar de ser uma resposta válida, e não um registro de erro, como no Negative Caching, impede a tradução correta do FQDN em seu endereço IP atual. Infográfico técnico: o processo de resolução DNS passo a passoVisualize a rota completa da consulta, do clique ao IP, com os comandos de terminal para auditar cada salto da hierarquia no novo material rico da ESR.➔ BAIXAR AGORA O comportamento do TTL: equilíbrio entre velocidade e propagação O TTL descalibrado está vinculado diretamente à configuração desse parâmetro nos servidores DNS autoritativos. O parâmetro de TTL (Time to Live) determina por quantos segundos um resolvedor recursivo tem autorização para reaproveitar uma resposta antes de realizar uma nova consulta ao servidor autoritativo. Na rotina de sustentação de redes, administrar esse valor envolve arbitrar um conflito direto entre desempenho e capacidade de reação: Parâmetro de TTL Vantagem para a rede Risco para a infraestrutura TTL Elevado(ex.: 86.400 segundos / 24h) Economiza banda de rede e reduz o processamento dos servidores autoritativos. Entrega consultas locais em menos de 1 ms. Retém endereços antigos no cache mundial durante as falhas. Trocas emergenciais de IP demoram horas para surtir efeito. TTL Reduzido(ex.: 60 segundos) Viabiliza a propagação imediata de novos IPs e manobras rápidas de contingência em servidores. Eleva a latência média das conexões de rede. Sobrecarrega servidores autoritativos com requisições repetitivas. Em ambientes com engenharia planejada, esse controle não é estático. Dias antes de uma manutenção estrutural no sistema DNS, a equipe técnica reduz preventivamente o TTL para 300 segundos. Com isso, os intermediários descartam cópias antigas rapidamente. No momento da virada da aplicação, a propagação do novo endereço ocorre em poucos minutos. Concluída a migração e estabilizado o serviço, o TTL é reconfigurado para retornar aos valores habituais de produção. Da hipótese ao diagnóstico: roteiro técnico de investigação com o utilitário dig Quando as hipóteses teóricas sobre caches, TTLs descalibrados ou delegações quebradas precisam ser comprovadas em produção, reiniciar serviços às cegas apenas prolonga o incidente. O diagnóstico efetivo demanda inspecionar a resposta que trafega no circuito de rede. O utilitário dig (Domain Information Groper) – padrão canônico de depuração em sistemas baseados em Unix e mantido pelo consórcio ISC (Internet Systems Consortium) – permite analisar as respostas do protocolo diretamente no terminal. Para isolar exatamente em qual camada a resolução foi interrompida, o administrador deve seguir uma sequência ordenada de testes: Teste de cache no resolvedor local dig @192.168.1.1 app.empresa.com.br +norecurseFinalidade: avalia se o resolvedor corporativo possui a resposta retida em memória sem disparar tráfego para a internet. A ausência do registro na seção ANSWER indica que o dado não está no cache local (comportamento padrão para consultas inéditas). Para verificar se existe uma falha de comunicação externa, deve-se executar o comando removendo o parâmetro “+norecurse”. Caso a consulta retorne SERVFAIL ou sofra timeout, fica confirmado que o resolvedor local não consegue se comunicar com os servidores autoritativos. Rastreamento da hierarquia iterativa completa dig app.empresa.com.br +traceFinalidade: percorre a árvore do DNS com base nos servidores raiz, passa pelo TLD (.br) e chega até o servidor autoritativo. Como o próprio utilitário executa as consultas iterativas passo a passo, o ponto exato em que a saída congelar (timeout) ou retornar uma resposta de erro (SERVFAIL ou REFUSED) revela qual nível da hierarquia interrompeu a resolução. Consulta direta à autoridade da zona dig @ns1.empresa.com.br app.empresa.com.brFinalidade: força o envio da requisição diretamente para o servidor que custodia a zona oficial da organização (servidor autoritativo), ignorando qualquer cache intermediário. Permite validar a resposta oficial do domínio e identificar se há divergências nos apontamentos entregues ao público por outros servidores de nomes ou resolvedores. Caso a consulta ao servidor principal apresente-se íntegra, deve-se verificar a consistência do ambiente consultando também os demais servidores autoritativos da zona (como o secundário ns2.empresa.com.br); se um servidor retornar um registro diferente ou um número de série (SOA Serial Number) defasado, fica caracterizada uma falha na replicação ou na transferência de zona (AXFR/IXFR). Validação de integridade criptográfica dig @<servidor> app.empresa.com.br +dnssec +multilineFinalidade: verifica se a resposta foi assinada pela criptografia assimétrica. O parâmetro @<servidor> especifica o IP ou o hostname do servidor DNS de destino que processará a consulta. Quando direcionado para o servidor autoritativo da zona, por exemplo @ns1.empresa.com.br, o retorno exibirá os registros RRSIG e DNSKEY, confirmando que o domínio foi assinado na origem. Já quando apontado para um resolvedor recursivo validador, como o @8.8.8.8, o teste avalia a cadeia de confiança ponta a ponta: se a autenticação for bem-sucedida, o cabeçalho retornará NOERROR com a flag ad (Authenticated Data) e o registro RRSIG; caso haja quebra na cadeia de custódia ou chave expirada, o resolvedor recusará a entrega e retornará SERVFAIL com a seção ANSWER vazia para proteger o cliente. Adicionalmente, em conjunto com os testes apresentados, é importante avaliar a saída do utilitário dig, observando os códigos de status de retorno (RCODE): NOERROR: a consulta obteve retorno válido, com os registros expostos na seção ANSWER. Se a aplicação continuar inacessível, o problema não está no DNS, devendo a apuração migrar para certificados TLS, balanceadores ou portas de firewall. NXDOMAIN: o nome consultado não existe na zona autoritativa. Exige conferir a grafia no arquivo de configuração e checar se os registros de endereço (A/AAAA) ou de apelidos (CNAME) foram declarados corretamente. SERVFAIL: o resolvedor não conseguiu obter retorno dos servidores autoritativos. Aponta diretamente para bloqueios na porta 53 UDP/TCP, servidores primários fora do ar sem secundário funcional ou falha matemática na validação de chaves DNSSEC. Além da resolução: mecanismos de proteção e integridade no DNS Restabelecer a resposta de uma consulta devolve a disponibilidade imediata, mas não garante a legitimidade do tráfego recebido. Em termos de segurança de infraestrutura, uma resposta com status NOERROR pode ocultar uma interceptação em trânsito se a rede aceitar dados sem verificação de integridade. O protocolo clássico de DNS transporta dados em texto claro e aceita qualquer pacote entregue na porta correta com o identificador de transação esperado. Essa característica estrutural abriu espaço para ataques de homem no meio (Man-in-the-Middle), desvios de rota e falsificações que atingem a operação antes mesmo de qualquer alerta em firewalls de borda. A segurança moderna da infraestrutura exige controles em camadas bem definidos: · Validação criptográfica de ponta a ponta com DNSSEC (RFC 4033 / RFC 4035): O protocolo adiciona autenticidade à zona por meio de assinaturas criptográficas (RRSIG), verificadas pelas chaves públicas da própria zona (DNSKEY) e ancoradas na zona superior por registros de delegação assinada (DS). O resolvedor recursivo valida a assinatura digital antes de entregar a resposta à aplicação. Se houver alteração do pacote em trânsito, a cadeia de confiança quebra e a resposta adulterada é rejeitada de imediato, retornando SERVFAIL ao cliente. · Mitigação ativa de envenenamento de cache (RFC 5452): No ataque de Cache Poisoning, o invasor bombardeia o resolvedor recursivo com respostas UDP forjadas tentando acertar o identificador de transação. A defesa técnica implementada em servidores contemporâneos baseia-se na aleatorização sistemática da porta de origem (Source Port Randomization) e no descarte estrito de registros fora do escopo de autoridade da zona consultada (Bailiwick checking). · Criptografia no canal cliente-resolvedor com DoT (RFC 7858) e DoH (RFC 8484): Enquanto o DNSSEC assegura a integridade dos dados na origem, o DNS over TLS (DoT) e o DNS over HTTPS (DoH) encapsulam a requisição em túneis criptografados entre os dispositivos e o resolvedor, impedindo a espionagem passiva (eavesdropping), a inspeção não autorizada do histórico de navegação e a manipulação de consultas em redes locais corporativas ou conexões públicas. ________________Leia mais: Arquitetura Zero Trust: 5 passos para implementar a abordagem na TI Fundamentos consolidados reduzem o tempo de inatividade Problemas complexos de rede não encontram resolução sustentável em tentativas aleatórias de reinicialização de serviços. Quando administradores conhecem apenas painéis de gestão e desconhecem a mecânica dos protocolos que suportam o tráfego, manutenções rotineiras e falhas de zona transformam-se em horas de indisponibilidade e perdas financeiras severas. A redução consistente do tempo médio de recuperação (MTTR) exige que a equipe de tecnologia domine a correlação direta entre pacotes de rede, tempos de retenção em cache e diretrizes normativas da internet. Diagnosticar a infraestrutura com base na raiz lógica dos protocolos assegura estabilidade operacional e antecipa incidentes graves de conectividade. A Escola Superior de Redes (ESR) desenvolve competências práticas dos profissionais responsáveis por planejar, sustentar e defender operações de missão crítica no país. Por meio de laboratórios aplicados e cenários reais de diagnóstico, as formações técnicas abrangem desde a arquitetura de protocolos de rede até estratégias avançadas de ciberdefesa e governança de infraestruturas. Aprofunde o domínio técnico da sua equipe nas áreas de formação da ESR: · Administração e Projeto de Redes· Segurança de Sistemas e Ciberdefesa· nGovernança e Infraestrutura de TI CONHEÇA AS FORMAÇÕES DE REDES DA ESCOLA SUPERIOR DE REDES Perguntas frequentes sobre falhas de DNS na infraestrutura (FAQ) Qual é a diferença prática entre um resolvedor recursivo e um servidor autoritativo? O resolvedor recursivo localiza o endereço IP percorrendo a hierarquia do DNS na internet em nome do cliente, podendo responder imediatamente caso possua a informação em cache. Já o servidor autoritativo custodia os registros oficiais e originais da zona DNS, sendo a fonte definitiva para parâmetros de apontamento e valores de TTL. Por que o comando ping falha, mas a consulta por dig obtém resposta? O comando dig realiza consultas diretas por meio de protocolo DNS na porta 53 UDP/TCP, ignorando o cache local da máquina. Já o ping depende da resolução do sistema operacional e de pacotes ICMP. Se houver bloqueio de ICMP em firewalls ou retenção de erro no cache local (Negative Caching), o ping falhará mesmo com o DNS externo funcional. De que forma o DNSSEC previne ataques de redirecionamento de tráfego? O DNSSEC utiliza criptografia assimétrica para assinar digitalmente os conjuntos de registros de uma zona (RRSIG, DNSKEY e DS). O resolvedor recursivo valida a integridade da assinatura digital antes de entregar a resposta à aplicação. Caso um cibercriminoso tente adulterar a resposta em trânsito (DNS spoofing ou envenenamento de cache), a assinatura torna-se inválida e o servidor rejeita o pacote. Qual é o impacto de pacotes EDNS0 bloqueados em redes corporativas? A extensão EDNS0 (RFC 6891) expande o tamanho máximo do buffer UDP para além do limite tradicional de 512 bytes, necessários para transportar as chaves e assinaturas do DNSSEC. Firewalls de borda desatualizados ou regras de inspeção restritivas que descartam esses pacotes por interpretá-los como anomalias geram timeouts, fragmentações e falhas intermitentes de resolução em toda a rede. ________________________Referências normativas da publicação
29/10/2026 -
 Computação em NuvemO object storage imutável transcende a visão tradicional de um mero repositório secundário de baixo custo, consolidando-se hoje como o pilar central na arquitetura de resiliência e continuidade de negócios. Trata-se de uma arquitetura de armazenamento em nuvem que impede a alteração, sobrescrita ou exclusão deliberada de dados durante um período de retenção predeterminado. Ao combinar o modelo de gravação única e leitura múltipla (Write Once, Read Many – WORM) com políticas de bloqueio nativas, a abordagem assegura que repositórios de backup permaneçam inalterados mesmo que os invasores tenham acesso total a credenciais administrativas. O Relatório do Cenário Global de Ameaças da Fortinet registrou um salto de 389% no número de vítimas confirmadas de ransomware globalmente (passando de cerca de 1.600 para 7.831 organizações impactadas em um único ano), impulsionado por um ecossistema que registrou quase 122 bilhões de tentativas de exploração automatizadas. Nesse modelo operacional de alta velocidade, no qual invasores utilizam a automação para explorar vulnerabilidades rapidamente, a exposição de identidades atua como o principal vetor de intrusão em ambientes de nuvem. Com mais de 4,6 bilhões de registros de credenciais vazadas circulando na darknet, os criminosos não precisam quebrar defesas complexas; eles realizam login com contas legítimas e utilizam chamadas de API para sabotar a infraestrutura por dentro. Sob essa dinâmica, os agentes maliciosos têm como alvo primário a localização e a destruição de rotinas de backup para inviabilizar qualquer tentativa de restauração antes de executarem a criptografia principal. Por isso, manter cópias de segurança em sistemas de arquivos tradicionais ou compartilhamentos de rede locais deixa o ambiente desprotegido contra invasores munidos de credenciais administrativas. A implementação de uma política de imutabilidade baseada em armazenamento de objetos elimina tal vulnerabilidade, permitindo que o dado original permaneça inacessível para exclusão ou adulteração, independentemente do nível de privilégio obtido no ataque. __________________________Síntese: a automação do cibercrime acelerou o comprometimento de credenciais válidas, permitindo que atacantes apaguem cópias de segurança antes de disparar a criptografia de produção. O object storage imutável aplica o modelo WORM (Object Lock) e requisições por meio de uma API REST, bloqueando qualquer tentativa de exclusão ou modificação de dados mesmo por identidades com privilégios de Root ou Administrador. O novo comportamento do ransomware A sofisticação das ameaças corporativas transformou o sequestro de dados em uma operação estruturada em duas etapas. Resumo: VETOR DE ATAQUE INDUSTRIALIZADO FASE 1: SABOTAGEM SILENCIOSA FASE 2: EXECUÇÃO DO PAYLOAD • Uso de credenciais válidas• Exclusão de cópias sombra • Sobrescrita de shares SMB• Destruição do catálogo • Criptografia de servidores • Paralisação operacional• Extorsão com base na perda total de redundâncias Nesse modelo de ataque, manter apenas cópias redundantes sem proteção contra exclusão não garante a continuidade dos negócios. A preservação da infraestrutura exige um backup imutável contra ransomware, isto é, repositório logicamente isolado, assegurando que os dados gravados permaneçam matematicamente e logicamente protegidos de qualquer comando de alteração até o término do prazo de retenção definido pela governança da empresa. _________________Leia mais: Arquitetura Zero Trust: 5 passos para implementar a abordagem na TI Por que o armazenamento de objetos supera sistemas de blocos e arquivos em resiliência? O armazenamento de objetos organiza a informação em um espaço de endereçamento plano (flat address space ou storage pool), eliminando a hierarquia de diretórios dos sistemas de arquivos (File Storage) e a divisão em setores de baixo nível típica do armazenamento em blocos (Block Storage). Conforme documentado pelas arquiteturas de nuvem de referência, como o Google Cloud Storage, cada unidade gravada no repositório é gerenciada como um objeto independente composto por três elementos essenciais: Conceito-chave: a arquitetura WORM (Write Once, Read Many – gravação única, leituras múltiplas) na nuvem estabelece um bloqueio lógico diretamente na API do repositório, rejeitando qualquer tentativa de exclusão ou modificação do dado até que o prazo de retenção seja concluído. Essa estrutura confere vantagens diretas de segurança e resiliência diante dos métodos legados de armazenamento: 1. Comunicação exclusiva por meio de chamadas programáticas (API REST) Diferentemente de volumes de disco montados no sistema operacional que herdam as permissões locais da máquina, o armazenamento de objetos opera por meio de chamadas HTTP/HTTPS (padrão S3 API e RESTful APIs). Isso impede que malwares em execução na rede local acessem diretamente o repositório como se fosse um diretório compartilhado. 2. Desacoplamento entre credenciais locais e plano de armazenamento Se um invasor obtém privilégios de Administrador local ou Root em um servidor Windows ou Linux, ele consegue destruir partições físicas e sistemas de arquivos locais. Contudo, ele não possui autoridade sobre o bucket em nuvem, cujo acesso é controlado por políticas de identidade (IAM), assinaturas de cabeçalho e chaves de acesso segregadas. 3. Modelo otimizado para dados estáticos (WORM Nativo) Enquanto o armazenamento em blocos atende a dados transacionais que mudam a cada milissegundo, o armazenamento de objetos foi concebido para o modelo de gravação única e leitura múltipla. Essa característica arquitetural torna a aplicação de travas de imutabilidade nativa e altamente eficiente para repositórios de segurança. Por que comparar arquiteturas de armazenamento na estratégia de defesa? A escolha da tecnologia de armazenamento impacta não apenas o desempenho da aplicação,mas também define a superfície de ataque exposta a ameaças corporativas. Enquanto o armazenamento em blocos atende a bancos de dados transacionais com baixa latência e o armazenamento em arquivos organiza documentos legados da rede corporativa, ambos dependem de pontos de montagem e permissões do sistema operacional local. Essa dependência permite que invasores com privilégios administrativos sobrescrevam ou excluam volumes inteiros durante uma intrusão. Compreender as diferenças estruturais entre esses modelos é o primeiro passo para estruturar um backup imutável contra ransomware, identificando por que o object storage imutável viabiliza uma Arquitetura worm na nuvem* com níveis de resiliência que sistemas legados não conseguem replicar. __________________*Relembre – Write Once, Read Many (gravação única, leituras múltiplas), no qual a própria API de armazenamento bloqueia qualquer instrução de alteração ou exclusão do dado até o término do prazo de retenção. Comparativo visual – Block Storage vs. File Storage vs. Object Storage Parâmetro de avaliação Block storage (discos / SAN) File storage (NAS / Pastas) Object storage (Nativo em nuvem) Estrutura de dados Blocos raw de baixo nível. Árvore hierárquica (diretórios). Repositório plano (pool de objetos). Protocolo de acesso iSCSI, Fibre Channel, NVMe-oF. SMB, NFS. API REST (HTTP/HTTPS, S3 API) Metadados Inexistentes no nível do bloco. Básicos (data, tamanho, autor). Ricos, extensíveis e customizáveis. Vulnerabilidade local Alta (formatável por meio do OS local) Alta (propagação direta na LAN). Isolada (sem ponto de montagem no OS). Retenção e Integridade Snapshots no nível do volume. Permissões ACL de diretório. Imutabilidade WORM Escalabilidade Restrita pela controladora/disco. Limitada pela árvore de arquivos. Ilimitada (escala horizontal até exabytes). O object storage imutável substitui a estratégia de backup tradicional? Uma dúvida recorrente entre arquitetos e administradores de sistemas é se a adoção do armazenamento de objetos com bloqueio WORM elimina a necessidade dos modelos consolidados de proteção. A resposta técnica é direta: o object storage imutável não substitui a metodologia de backup, mas eleva o seu nível de maturidade operacional. Ele atua como a evolução da clássica regra 3-2-1 para o padrão moderno 3-2-1-1-0: Em vez de descartar as rotinas existentes, a infraestrutura integra o repositório de objetos como o destino final e blindado das cópias secundárias, assegurando que o plano de continuidade sobreviva mesmo na eventualidade de perda total do ambiente local. Pilares da arquitetura anti-ransomware no Object Storage A implementação de um repositório imutável apoia-se em três mecanismos fundamentais que operam de forma coordenada dentro da infraestrutura de nuvem: 1. Imutabilidade por Object Lock (WORM) Ao avaliar como funciona o Object Lock na API S3, o administrador de sistemas encontra a ferramenta central para impedir a destruição de dados. O bloqueio atua por meio de dois modos de período de retenção e um mecanismo complementar de retenção legal: 2. Versionamento automático (Versioning) Com o versionamento habilitado no bucket, qualquer tentativa de sobrescrever um arquivo não substitui o dado anterior; o sistema gera uma nova versão com identificador exclusivo, preservando o histórico intacto. Se um invasor enviar uma instrução simples de exclusão sem especificar o ID da versão, o repositório apenas insere um marcador de exclusão (Delete Marker), permitindo restaurar o estado limpo imediatamente. No entanto, se o invasor tentar uma exclusão permanente passando o ID da versão protegida (DeleteObject com versionId), é o Object Lock que atua como a barreira definitiva: a API do provedor intercepta a chamada e rejeita a exclusão física do objeto com erro HTTP 403 Forbidden até que o período de retenção expire. 3. Replicação geográfica segregada (Cross-Region Replication – CRR) Para proteger o ambiente da perda total de acesso à conta principal, a replicação entre regiões transfere as cópias imutáveis para buckets em contas isoladas (Separate Account Ownership). Dessa forma, mesmo que uma credencial do ambiente primário seja comprometida, o repositório secundário de contingência permanece inacessível ao invasor. FinOps no Storage: otimização de custos e controle A aplicação de travas de imutabilidade exige planejamento financeiro contínuo para equilibrar máxima segurança e previsibilidade orçamentária. 1. Políticas de ciclo de vida (Lifecycle Policies) O gerenciamento automático do ciclo de vida move os objetos entre classes de serviço conforme a perda de relevância operacional: A parametrização das políticas de ciclo de vida em buckets S3 precisa ser alinhada ao período de Object Lock, garantindo que as regras de transição não tentem descartar dados que ainda estejam sob vigência da trava WORM. 2. Previsão dos custos de egress no backup Provedores de nuvem geralmente não cobram pelo recebimento de dados (ingress), mas aplicam tarifas sobre a saída de tráfego (egress fees) quando as informações saem de sua infraestrutura. Para manter sob controle os custos de egress no backup durante auditorias e testes de recuperação de desastres (Disaster Recovery): _________________Leia mais: Parceria CompTIA e ESR: guia de certificações oficiais em TI Formação técnica em arquitetura de nuvem e segurança na ESR Projetar e administrar repositórios baseados em object storage imutável exige domínio prático em arquitetura de nuvem, gerenciamento de acessos (IAM) e resposta a incidentes. Decisões equivocadas na configuração de políticas WORM podem resultar em bloqueios permanentes irreversíveis ou em custos operacionais desnecessários. A Escola Superior de Redes (ESR), unidade de capacitação da RNP, oferece treinamentos práticos ministrados por especialistas homologados para capacitar equipes na administração de ambientes seguros: Perguntas frequentes sobre object storage imutável 1. O que acontece se uma conta Root tentar apagar um objeto protegido em Compliance Mode? A solicitação é rejeitada pela API do provedor de armazenamento com código de erro de acesso negado. No modo Compliance, a regra WORM atua no nível da infraestrutura de armazenamento, impedindo que qualquer identidade administrativa exclua ou altere a retenção do dado até que o prazo expire. 2. O uso de object storage imutável substitui a metodologia tradicional de backup? Não. Ele atualiza a metodologia 3-2-1 para o padrão 3-2-1-1-0 (três cópias dos dados, duas mídias distintas, uma cópia externa, uma cópia imutável e zero erros na validação periódica da restauração). 3. É possível ativar o Object Lock em um bucket já em produção? Em provedores como o AWS S3, o Object Lock já pode ser habilitado diretamente em buckets existentes pelas propriedades do repositório. No entanto, a regra não é retroativa: para proteger objetos pré-existentes, o administrador precisa aplicar a política de retenção aos arquivos legados (usando S3 Batch Operations ou chamadas de API), ou migrar o conjunto de dados para um bucket recém-configurado. 4. Qual é a diferença operacional entre Legal Hold e período de retenção? O período de retenção estabelece um prazo numérico determinístico (por exemplo, 30 ou 90 dias) após o qual a trava expira automaticamente. O Legal Hold é uma sinalização booleana de auditoria sem data final, que mantém o objeto bloqueado para exclusão até que a flag seja removida manualmente por um operador autorizado.
22/10/2026 -
 Governança de TIComo a sua organização valida a legitimidade de um usuário quando credenciais válidas podem ser capturadas por páginas clonadas ou concedidas sob manipulação psicológica? A integração de recursos de IAM com biometria utiliza características físicas ou comportamentais para apoiar a etapa de autenticação, validando a identidade do solicitante antes que as políticas de controle e autorização definam suas permissões no ambiente corporativo. Em vez de apoiar a verificação exclusivamente em senhas tradicionais, essa abordagem permite estruturar mecanismos substancialmente mais resistentes a ataques modernos de engenharia social. A necessidade dessa evolução acompanha uma transformação profunda no comportamento das ameaças digitais. Ferramentas de inteligência artificial automatizam campanhas direcionadas de spear phishing, reproduzem padrões de comunicação institucional com alto grau de fidelidade e exploram vetores de persuasão em escala. Procedimentos de integração de novos usuários, recuperação de contas e verificação cotidiana tornam-se alvos críticos quando fraudadores utilizam vídeos sintéticos e clonagem de voz para enganar operadores e obter acesso legítimo sem a necessidade de quebrar credenciais por força bruta. Nesse cenário, o invasor raramente precisa violar uma criptografia complexa. Convencer um colaborador legítimo a aprovar uma solicitação em contexto aparentemente confiável tornou-se suficiente (e mais barato) para comprometer perímetros corporativos inteiros. Essa realidade explica por que diferentes métodos de autenticação oferecem níveis distintos de proteção, inclusive em arquiteturas de Autenticação Multifator (MFA). Enquanto notificações simples de aprovação (push) sofrem com ataques de fadiga (MFA Fatigue) e códigos temporários (SMS ou OTP) podem ser interceptados em páginas de phishing reverso (Adversary-in-the-Middle), autenticadores modernos baseados em padrões abertos – como FIDO2 e WebAuthn – vinculam criptograficamente a credencial ao domínio legítimo do serviço (verifier name binding), assegurando resistência nativa a interceptações. Além disso, validar quem é o usuário apenas no instante inicial do login não oferece garantias suficientes para infraestruturas distribuídas entre nuvem, dispositivos móveis e acessos remotos. Ao combinar biometria física ou comportamental com análise de contexto e avaliação contínua de risco ao longo da sessão, o IAM mitiga a dependência de senhas estáticas e fortalece a postura corporativa em modelos de Segurança Zero Trust. Ao longo deste artigo, você entenderá como funcionam os modelos de autenticação passwordless, qual o papel da biometria comportamental na estratégia Zero Trust, quais cuidados precisam ser considerados em relação à LGPD e por que a identidade digital se consolidou como uma das principais camadas de defesa da segurança moderna. Se você deseja aprofundar os fundamentos da Gestão de Identidade e Acesso, vale conferir também o conteúdo da ESR: Gestão de Identidade e de Acesso (IAM): saiba se você realmente entende esse conceito! Como a gestão de identidade e acesso evolui? Políticas rígidas de complexidade de caracteres e trocas periódicas obrigatórias por calendário representaram, durante anos, a resposta padrão das organizações para tentar reduzir riscos de invasão. O cenário contemporâneo de ameaças, contudo, demandou revisões metodológicas profundas. Diretrizes técnicas de referência internacional, como a publicação especial NIST SP 800-63B – adotada como parâmetro de boas práticas por equipes de engenharia, sem caráter de imposição legal no Brasil -, recomendam expressamente não forçar a troca arbitrária de senhas por tempo. A exigência de renovações frequentes induz o usuário à fadiga cognitiva e à criação de variações previsíveis e mais fracas da mesma senha, devendo a alteração ser exigida apenas mediante evidências concretas de comprometimento. Além disso, grande parte das invasões corporativas não depende da quebra matemática de hashes. O foco do cibercrime migrou para a persuasão comportamental, abusos de engenharia social assistidos por IA e indução de acessos legítimos. Diante dessa realidade, a gestão de identidade e acesso não foi substituída por uma “nova disciplina”, mas evoluiu para incorporar camadas adaptativas: análise contextual contínua, avaliação dinâmica de risco ao longo da sessão e mecanismos de autenticação resistentes a interceptações. 1. Autenticação passwordless e a redução da dependência de senhas A expansão da autenticação passwordless (sem senha) visa eliminar a superfície de ataque mais visada pelo cibercrime: o tráfego e o armazenamento de credenciais compartilhadas suscetíveis a vazamentos, repetição de senhas e phishing. No entanto, eliminar a digitação da senha não assegura automaticamente resistência a phishing. Essa blindagem decorre de padrões abertos como FIDO2 e WebAuthn, cuja criptografia assimétrica baseada em par de chaves pública e privada vincula o processo de autenticação ao domínio legítimo do serviço (origin binding), impedindo que credenciais sejam capturadas por páginas falsas ou proxies reversos. As passkeys utilizam esse modelo criptográfico e operam sob duas dinâmicas distintas de custódia: É fundamental notar que a passkey não é uma modalidade de biometria. A validação biométrica (ou a digitação de um PIN de desbloqueio) funciona estritamente no dispositivo local como um fator de ativação para liberar o uso da chave privada. Esse dado biométrico jamais é transmitido para o servidor ou para a aplicação. Para que a implementação seja reconhecida tecnicamente como Autenticação Multifator (MFA), o sistema precisa exigir e validar formalmente dois fatores distintos: a posse do dispositivo criptográfico (“algo que você tem”) associada à ativação local por biometria (“algo que você é”) ou PIN/senha (“algo que você sabe”). 2. IAM com biometria, indicadores de risco e avaliação de sessão O IAM pode incorporar a biometria em duas frentes distintas – como fator de autenticação física e como componente complementar de monitoramento. Para a engenharia de segurança e normativas técnicas como o NIST SP 800-63B, a biometria isolada não constitui um autenticador completo, pois não representa um segredo criptográfico nem garante presunção absoluta de posse. Ela atua como fator legítimo de autenticação quando vinculada a um autenticador físico em processos multifator. Já a chamada biometria comportamental atua como sinal complementar de telemetria e análise de risco, não devendo ser confundida com um fator de autenticação formal nem com variáveis puramente de ambiente. Nesse ecossistema, distinguem-se duas naturezas de dados: Ao avaliar esses dados de forma contínua durante a sessão, a solução de governança pode auxiliar na detecção precoce de anomalias, indicando suspeitas de movimentação atípica ou comprometimento de permissões. Entretanto, essa abordagem exige calibração rigorosa de regras: a equipe técnica precisa acompanhar de perto as taxas de falsos alertas e bloqueios indevidos, sob o risco de degradar a experiência do colaborador legítimo e gerar atrito operacional severo para os times de suporte. Como o controle de acesso se conecta ao Zero Trust? Diferente de um senso comum recorrente, a arquitetura Zero Trust (conforme descrita na norma NIST SP 800-207) não depende de biometria para ser implementada. A biometria é um dos múltiplos elementos que podem compor a estratégia de verificação de identidade, mas o núcleo do modelo reside no princípio de que nenhuma conexão, dispositivo ou solicitação de acesso deve ser considerada implicitamente confiável, esteja ela dentro ou fora da rede corporativa. A premissa da verificação contínua no Zero Trust não implica solicitar leituras faciais ou digitais repetitivas a cada clique ou transação do colaborador. Em vez de atrito contínuo, as soluções avaliam sinais de risco em segundo plano. Quando o mecanismo detecta uma alteração sensível de contexto – como uma transição abrupta de endereço IP ou uma tentativa de conexão a um banco de dados restrito fora do horário operacional -, a política de risco decide de forma proporcional se deve: Ao estruturar essas políticas de forma coordenada, a organização mitiga a movimentação lateral na rede corporativa e protege dados sensíveis sem sobrecarregar desnecessariamente o fluxo diário de trabalho. Como alinhar IAM com biometria às exigências da LGPD? O alinhamento entre a integração de IAM com biometria e a Lei Geral de Proteção de Dados (LGPD – Lei nº 13.709/2018) depende da fundamentação do tratamento no regime específico de dados pessoais sensíveis, uma vez que a informação biométrica está associada a uma pessoa natural identificada ou identificável. No contexto corporativo de segurança da informação, a hipótese legal que habitualmente sustenta a autenticação biométrica é o artigo 11, inciso II, alínea g da LGPD: garantia de prevenção à fraude e à segurança do titular nos processos de identificação e autenticação de cadastro em sistemas eletrônicos. Para a incidência legítima dessa base, o tratamento deve ser indispensável à finalidade pretendida, resguardados os direitos previstos no artigo 9º da lei, e desde que não prevaleçam os direitos e as liberdades fundamentais do titular que exijam a sua proteção. É imperativo observar duas distinções regulatórias críticas: Adicionalmente, a elaboração do Relatório de Impacto à Proteção de Dados Pessoais (RIPD) não decorre como obrigação automática para todo e qualquer uso de biometria, mas fundamenta-se na gestão de riscos da operação – em especial quando envolver monitoramento em larga escala ou decisões automatizadas -, cabendo lembrar que a Autoridade Nacional de Proteção de Dados (ANPD) detém competência para determinar sua apresentação com base no artigo 38 da lei. Comparação local vs. centralizada e a natureza dos templates biométricos Soluções biométricas podem adotar comparação local ou centralizada. Essa definição não decorre de preferências operacionais genéricas, mas de uma escolha de arquitetura pautada pela necessidade, riscos envolvidos, finalidade do acesso e controles implementados, com o objetivo de evitar a concentração excessiva de dados sensíveis. Comparação centralizada Comparação local (recomendada) Templates em servidorRisco de vazamento massivo Tráfego contínuo em redeSuperfície de ataque ampla Templates confinados no endpointProcessamento isolado em hardware seguroLiberação local de chaves de autenticação Menor superfície de exposição de PII Sistemas biométricos podem utilizar templates biométricos, que são representações matemáticas extraídas de amostras físicas (como minúcias de impressões digitais ou mapas geométricos da face). Nesse contexto, é fundamental estabelecer que o template biométrico: Priorizar a verificação biométrica local pode reduzir a exposição a vazamentos de bases centralizadas. O armazenamento e o fluxo de processamento variam conforme o ecossistema: no Windows Hello, por exemplo, os templates ficam guardados localmente em bases criptografadas do sistema operacional; já no Windows Hello for Business, o chip Trusted Platform Module (TPM), quando disponível, atua para proteger e isolar as chaves de autenticação, liberando seu uso somente após a correspondência do template local. O cuidado é ainda maior porque, diferentemente de uma senha ou token vazado, que pode ser revogado e substituído em segundos, uma característica biométrica violada não pode ser reemitida ou alterada. Biometria comportamental e o regime de dados pessoais sensíveis Na biometria comportamental, a análise de padrões de digitação, dinâmica de cursor e interações de tela é frequentemente associada à minimização de dados sob o argumento de que a ferramenta não registra fotos nem impressões digitais. Essa leitura, contudo, carece de respaldo legal: a ausência de nome de registro ou de imagem fotográfica não afasta a incidência da LGPD. Quando perfis estatísticos de interação permitem identificar ou individualizar uma pessoa natural de forma determinística ou probabilística, o tratamento permanece submetido ao regime protetivo da legislação. Se essas inferências e métricas contínuas são utilizadas especificamente para autenticar ou reconhecer um indivíduo com base em suas características comportamentais intrínsecas, aplica-se o regime legal de dados sensíveis. Ademais, conforme estabelece o artigo 20 da LGPD, o titular tem o direito de solicitar a revisão de decisões tomadas unicamente com base no tratamento automatizado de dados pessoais que afetem seus interesses. Se um algoritmo de biometria comportamental identificar uma anomalia estatística de ritmo e disparar o bloqueio compulsório de um colaborador legítimo em sua estação de trabalho, a política de governança deve prever mecanismos humanos para a contestação e o desbloqueio assistido desse acesso. Boas práticas para a implementação de biometria corporativa com menor risco A estruturação de projetos de autenticação sem senha e IAM integrado à biometria exige convergência entre arquitetura técnica, diretrizes do NIST SP 800-63B e conformidade jurídica. Entre as práticas mais recomendadas para ambientes corporativos, destacam-se: Também existe um componente operacional importante relacionado com a conscientização interna. Ataques associados à identidade digital continuam explorando a engenharia social, o comportamento humano e o uso inadequado de credenciais legítimas. Por isso, a maturidade em Segurança Zero Trust depende não apenas de tecnologia, mas também de capacitação contínua das equipes responsáveis por administrar acessos corporativos. De acordo com esse cenário, o IAM com biometria se consolida como uma camada adicional de proteção para ambientes altamente distribuídos, aplicações críticas e operações conectadas entre nuvem, dispositivos móveis e acessos remotos. 💡Você também pode gostar – Segurança da Informação: quais são os fundamentos que realmente importam? O futuro da autenticação corporativa passa pela especialização técnica Com a adoção de modelos como IAM com biometria, autenticação contínua e Segurança Zero Trust, equipes de tecnologia lidam hoje com desafios que vão além da implementação operacional das ferramentas. Profissionais capazes de interpretar risco, definir políticas de acesso coerentes, estruturar governança de identidade e tomar decisões alinhadas à realidade regulatória e operacional das empresas tendem a ocupar um espaço cada vez mais estratégico dentro das operações de TI. Além disso, equipes de infraestrutura, segurança, redes, cloud, compliance e administração de acessos corporativos convivem diariamente com responsabilidades ligadas a controle de privilégios, proteção de credenciais, monitoramento de sessões e tratamento adequado de dados sensíveis. Por isso, investir em capacitação se tornou parte importante da maturidade de segurança das organizações. Como preparar equipes de TI para os novos desafios de identidade digital Para profissionais e times de TI que desejam aprofundar conhecimentos sobre governança, proteção de acessos, gestão de riscos e segurança da informação, a ESR oferece o curso Gestão de Riscos de Segurança da Informação e Privacidade (SRC-003). A formação aborda conceitos relacionados com proteção corporativa, análise de riscos, privacidade, governança e estratégias alinhadas aos desafios atuais da cibersegurança. Garantir a minha inscrição! Perguntas frequentes sobre IAM com biometria IAM com biometria é um modelo de gestão de identidade e acesso que utiliza características físicas ou comportamentais do usuário para validar sua identidade nos ambientes corporativos. Biometria comportamental utiliza padrões como ritmo de digitação, movimentação do mouse e comportamento de navegação para identificar usuários legítimos durante toda a sessão. O MFA continua importante, mas ataques como phishing avançado e MFA Fatigue mostraram limitações importantes quando a autenticação depende exclusivamente da aprovação humana. Autenticação passwordless é um modelo de acesso que elimina o uso tradicional de senhas, utilizando passkeys, biometria, dispositivos confiáveis e chaves criptográficas. Pode estar, desde que o tratamento tenha base legal adequada, finalidade definida, coleta necessária, medidas de segurança Quero conhecer as Trilhas de TI da ESR ___________________________________ Referências bibliográficas
15/10/2026 -
 Desenvolvimento de SistemasLógica de programação é a capacidade de organizar instruções de forma sequencial, coerente e objetiva para que um computador execute uma tarefa corretamente. Em outras palavras, trata-se da base que permite transformar um problema em uma sequência estruturada de ações dentro da programação. Entre as habilidades técnicas iniciais que desenvolvedores precisam dominar, talvez esse conhecimento seja o mais importante. Isso porque ele funciona como o elemento responsável por estruturar, de maneira racional, os passos que um algoritmo deve seguir para alcançar determinado resultado. Sem essa base, aprender sintaxe, frameworks ou até mesmo diferentes linguagens de programação tende a se tornar um processo muito mais difícil. Assim, de forma geral, dizemos que a lógica de programação, ou lógica computacional, refere-se à técnica de desenvolver sequências lógicas, a fim de obter um resultado específico. As sequências, por sua vez, são adaptadas às linguagens de programação para, a partir daí, traduzirem-se em comandos de ação para as máquinas. Nesse contexto, sabendo que um computador entende qualquer instrução de maneira literal, a lógica de programação atua como uma moldura didática que orienta a máquina a seguir pelo caminho desejado pelo programador. Tal relação prática se dá por meio do algoritmo, que é um fluxo computacional criado para resolver um problema ou, para melhor entendimento, um roteiro que detalha os procedimentos necessários para a realização ou resolução de uma atividade. Existem algumas formas de representar tais algoritmos, e a escolha delas depende do projeto a ser elaborado e da preferência do desenvolvedor. É o caso: Exatamente por performar como uma base objetiva de instruções para uma máquina funcionar é que a lógica de programação é tão importante para quem deseja começar na carreira de desenvolvimento. Neste artigo, vamos conversar sobre os principais tópicos acerca desse tema, além de indicar o passo a passo crucial para você dar o start nos estudos da área. ➡️ Leia também: 8 dicas para iniciar na carreira de programação Quais são os conceitos básicos da lógica de programação? Como dissemos anteriormente, a lógica computacional representa uma das habilidades primárias da programação, que permite ao programador estruturar seu raciocínio e projetos em comandos específicos (códigos) para conseguir se comunicar com a máquina. Nada mais é, portanto, do que a materialização de um raciocínio lógico. Porém, para dominar esse know-how, é necessário compreender os conceitos básicos por trás da lógica de programação. São eles: 1) Algoritmos De acordo com Manzano, autor do livro Lógica para desenvolvimento de programação para computadores, algoritmos “são conjuntos de passos finitos e organizados que, quando executados, resolvem um problema”. Dessa forma, caracterizam-se por serem a receita que guia o computador na execução de tarefas. Por exemplo, para somar dois números, um algoritmo simples pode ser expresso assim: 1. Iniciar 2. Receber o primeiro número (a) 3. Receber o segundo número (b) 4. Somar a e b e armazenar o resultado 5. Exibir o resultado 6. Fim Resumindo, o algoritmo é a implementação prática da lógica de programação, uma receita com instruções literais que indica à máquina o que o programador pretende executar a partir de então. 2) Variáveis, constantes e tipos de dados As variáveis armazenam dados durante a execução de um programa. As constantes são valores fixos que não mudam. Já os tipos de dados definem a natureza dos valores que as variáveis podem armazenar, como “inteiros, decimais ou caracteres”. Esses elementos são importantíssimos para padronizar a informação em uma estrutura de lógica de programação, pois cada um deles associa um comando específico à máquina. Analogamente, vamos considerar uma situação na qual você está desenvolvendo um programa para calcular a área de um círculo. Nesse cenário, você usaria variáveis para armazenar o raio e o resultado, uma constante para representar π (pi) e tipos de dados para garantir que as informações sejam tratadas corretamente. Nesse exemplo, a variável serve para guardar valores que podem mudar durante o programa, como o raio do círculo e o valor da área calculada. A constante representa um valor fixo e conhecido, como o número π (pi), que sempre será o mesmo. Já os tipos de dados garantem que a máquina entenda corretamente a informação que está sendo usada – por exemplo, o raio pode ser um número decimal, então o tipo de dado precisa permitir isso para que o cálculo funcione sem erros. Esses três elementos juntos ajudam a organizar o código e assegurar que ele funcione como esperado. 3) Estruturas de repetição As estruturas de repetição permitem que um conjunto de instruções seja executado várias vezes, otimizando os processos de comunicação e da máquina. Uma vez que elas evitam a repetição manual de comandos, resultam em um código mais limpo e eficiente. Imagine a tarefa de imprimir os números de 1 a 5. Sem uma estrutura de repetição, seria necessário escrever uma instrução para cada número. Com uma estrutura de repetição, podemos fazer isso de forma mais eficiente, como no exemplo abaixo: 1. Iniciar 2. Para cada número de 1 a 5 faça: 3. Imprimir número 4. Fim 4) Operadores e condicionais Operadores são símbolos que instruem o compilador ou interpretador a executar manipulações matemáticas, relacionais ou lógicas sobre dados e variáveis. Na lógica de programação, esses elementos dividem-se em quatro categorias fundamentais: As estruturas condicionais determinam o desvio do fluxo de execução com base no resultado dessas avaliações. Em vez de executar instruções linearmente de cima para baixo, o algoritmo testa uma premissa lógica: se a condição for verdadeira, o bloco principal é processado; caso contrário, o fluxo é desviado para o bloco alternativo. A combinação entre atribuição, comparação e fluxo condicional resolve problemas como a validação de elegibilidade para votação: idade = ## (# variável com a idade da pessoa) se idade >= 18 então imprimir(“Você é elegível para votar.”) senão imprimir(“Você não pode votar ainda.”) Nessa estrutura, o operador de atribuição (=) define o valor inicial da variável. Em seguida, a condicional aplica o operador de comparação >=. Se o valor for igual ou superior a 18, o programa executa a primeira instrução. Caso a idade seja inferior, a condição falha e o fluxo é desviado imediatamente para o bloco senão, executando a mensagem alternativa sem exigir um novo teste lógico. ➡️ Leia também: As habilidades mais valorizadas no mercado de trabalho de Tecnologia da Informação Por que aprender lógica de programação? Se você deseja ingressar no mercado de programação, a lógica de programação é a porta de entrada. A aprendizagem desse tópico é fundamental, pois permite que os indivíduos compreendam e resolvam problemas de maneira estruturada, traduzindo conceitos abstratos em “instruções passo a passo” que são compreensíveis pelo computador. Ao dominarem esses conceitos, os programadores iniciantes ganham a habilidade de projetar soluções lógicas para uma ampla variedade de desafios, preparando o terreno para a aprendizagem de linguagens de programação específicas e o desenvolvimento de aplicações práticas. Além de ser a base essencial para a programação, a lógica de programação também fomenta a resolução de problemas de maneira mais abrangente, o que contribui para o pensamento crítico e para a potencialização da habilidade de decompor problemas complexos em partes mais gerenciáveis. Outro ponto de destaque que indica a necessidade dessa especialização é que, independentemente da linguagem de programação escolhida, a lógica subjacente permanece consistente. Ou seja, programadores podem se adaptar mais facilmente a novas tecnologias e ambientes de desenvolvimento ao saberem lógica de programação. Cinco dicas para começar o aprendizado em lógica de programação 1) Domine os conceitos básicos Antes de mergulhar profundamente em linguagens de programação específicas, é crucial estabelecer uma base sólida nos conceitos fundamentais da lógica de programação. Entenda algoritmos, estruturas de controle de fluxo (condicionais e iterativos/laços), variáveis e tipos de dados. Dessa forma, você terá uma compreensão clara de como as instruções são executadas e como os dados são manipulados, formando a espinha dorsal do desenvolvimento de software. 2) Aprofunde seu conhecimento em inglês Investir tempo no aprimoramento da língua inglesa é crucial no mundo da programação. Mesmo que de forma gradativa e combinada com outras aprendizagens, não deixe o estudo do inglês de lado. Afinal, muitos recursos, documentação e tutoriais estão disponíveis em inglês, desse modo, ter uma compreensão sólida dessa língua facilita a navegação e a assimilação de informações. Além disso, muitas linguagens de programação também são realizadas em inglês. Por isso, familiarizar-se com os termos técnicos em inglês não apenas enriquece sua compreensão dos conceitos, mas também amplia significativamente os recursos educacionais acessíveis a você. 3) Pratique regularmente A prática constante é essencial para desenvolver suas habilidades em lógica de programação. Resolva problemas práticos, participe de desafios de programação on-line e projete pequenos programas. Quanto mais você executa, mais confortável fica com a aplicação dos conceitos, evoluindo com a capacidade de pensar de maneira lógica para resolver problemas complexos. 4) Explore estruturas de dados Além de compreender os conceitos básicos de estruturas de dados, esteja familiarizado com diferentes métodos para ordenar e armazenar dados, como listas, pilhas e filas. Saber como organizar e acessar dados de maneira eficiente é crucial para o desenvolvimento de programas eficazes. Assim, experimente implementar essas estruturas em sua prática cotidiana para ganhar experiência. 5) Participe de comunidades e projetos colaborativos Essa é uma das dicas mais importantes para assimilar o que é lógica de programação e seu aprendizado. Engajar-se em comunidades de programação e colaborar em projetos compartilhados é uma maneira valiosa de aprender. Por meio dessa prática, você pode dividir conhecimento, obter feedback e observar como outros programadores abordam problemas. Além disso, a exposição a diferentes perspectivas e estilos de codificação enriquece sua compreensão da lógica de programação e proporciona uma aprendizagem mais holística. 6) Consuma conteúdos voltados para o tema Aprender lógica de programação exige prática constante, mas também depende da qualidade das referências utilizadas ao longo do processo de aprendizagem. Um dos erros mais comuns entre iniciantes é consumir conteúdos extremamente avançados antes de consolidar conceitos básicos ligados à lógica computacional, estruturas condicionais, algoritmos e organização do raciocínio lógico. Quando isso ocorre, a sensação de dificuldade costuma aumentar rapidamente. O estudante até consegue reproduzir códigos prontos, mas encontra obstáculos para compreender por que determinada solução funciona ou como adaptá-la a novos cenários dentro da programação. Por esse motivo, construir uma base sólida faz diferença no desenvolvimento técnico de longo prazo. Além da prática cotidiana, consumir materiais estruturados ajuda a desenvolver familiaridade com conceitos essenciais relacionados a como começar a programar, interpretação de problemas computacionais, funcionamento das linguagens de programação e estruturação de soluções lógicas aplicadas ao desenvolvimento de software. Nesse processo, vale buscar conteúdos que conectem teoria e aplicação prática, principalmente para quem ainda está nos primeiros contatos com o universo do desenvolvimento. Na ESR, existem materiais gratuitos e conteúdos especializados que ajudam a aprofundar gradualmente o entendimento sobre o que é lógica de programação, carreira em desenvolvimento e fundamentos técnicos da área. O material apresenta uma visão introdutória importante para quem deseja compreender melhor os primeiros passos no universo do desenvolvimento e das linguagens de programação. Nesse caso, a discussão avança sobre especialização técnica, evolução profissional e construção de carreira dentro do mercado de tecnologia. O conteúdo ajuda a visualizar como diferentes tecnologias possuem aplicações específicas no desenvolvimento de software, além de auxiliar quem ainda está escolhendo qual caminho seguir na área. Além dos artigos, a ESR também disponibiliza materiais ricos voltados para a formação técnica em desenvolvimento. Um dos principais é o novo e-book: ➡️ Lógica de programação: um guia completo para desenvolver carreiras em TI (Compreenda de ponta a ponta um dos principais conceitos do desenvolvimento de softwares, produtos e soluções tecnológicas) O material aprofunda conceitos fundamentais relacionados com a lógica de programação, algoritmos, estruturação do raciocínio computacional e construção de base técnica para quem deseja atuar com desenvolvimento de software. O e-book reúne informações importantes para quem ainda está entendendo: Todos os textos são gratuitos. Ao combinar prática, estudo contínuo e consumo de conteúdos especializados, o processo de aprendizagem tende a se tornar mais consistente, sobretudo para quem deseja construir uma base sólida na área de desenvolvimento e tecnologia. Qual a importância da lógica de programação no dia a dia de TI? Ao longo deste conteúdo, vimos que a lógica de programação não está restrita ao desenvolvimento de códigos ou à aprendizagem de uma linguagem específica. Ela funciona como a base que sustenta praticamente toda a tomada de decisão na área de tecnologia. Na prática, programar significa resolver problemas. E quanto mais estruturado for o raciocínio lógico por trás dessa solução, maiores tendem a ser a eficiência, a clareza e a capacidade de evolução de um projeto. Isso explica por que a lógica computacional continua sendo um dos conhecimentos mais valorizados para quem deseja atuar com desenvolvimento de software, automação, análise de dados, infraestrutura, inteligência artificial ou qualquer outra área ligada à tecnologia. Um profissional que domina os fundamentos da programação consegue interpretar cenários complexos com mais facilidade, dividir problemas em etapas menores e construir soluções mais organizadas, sustentáveis e eficientes. Além disso, a lógica influencia diretamente fatores importantes da rotina técnica, como: Em equipes de desenvolvimento, isso também impacta a colaboração. Códigos estruturados de forma lógica tendem a ser mais fáceis de compreender, documentar e evoluir ao longo do tempo, independentemente do tamanho da equipe ou da tecnologia utilizada. Outro ponto importante envolve adaptabilidade profissional. As tecnologias mudam constantemente. Frameworks evoluem, novas ferramentas surgem e diferentes linguagens de programação ganham espaço no mercado. Ainda assim, os princípios da lógica de programação permanecem essencialmente os mesmos. Por esse motivo, profissionais com boa base lógica normalmente conseguem aprender novas tecnologias com muito mais velocidade. Resumo: como a lógica de programação impacta a rotina em TI? Área da rotina técnica Impacto da lógica de programação Desenvolvimento de software Estruturação mais clara e eficiente de códigos Resolução de problemas Capacidade de decompor desafios complexos Aprendizagem de linguagens Facilidade para migrar entre tecnologias Performance de aplicações Redução de processamento desnecessário Trabalho em equipe Melhor organização e entendimento do código Manutenção de sistemas Maior previsibilidade e facilidade de atualização Escalabilidade Estruturas mais preparadas para crescimento futuro ➡️ Leia também: Que curso de tecnologia é feito para mim? Conheça as Trilhas ESR e descubra sua jornada de aprendizagem ideal! Escola Superior de Redes: a melhor escolha para o ensino e a aprendizagem de programação Neste conteúdo você aprendeu o que é lógica de programação e como se aperfeiçoar nessa prática. Este é o um dos textos exclusivos de uma série de posts sobre programação, da Escola Superior de Redes, referência em ensino e consultoria para tecnologia da informação. No blog de abertura, discutimos o universo das linguagens de programação (você pode ficar por dentro por aqui) e, agora, nosso próximo encontro apresentará quais delas são as mais populares para o cenário atual. Acompanhe a produção do nosso blogpost, além das mídias, para ficar por dentro das novidades em TI e receber informações inéditas dos cursos da ESR e dessa coleção de artigos para desenvolvedores iniciantes! Ei, ainda temos dois e-books gratuitos por aqui! Se você chegou ao final deste conteúdo, merece uma faixa bônus 😉 Baixe agora nossos e-books gratuitos sobre o universo das linguagens da programação e sobre a lógica de programação – assuntos extras! E-book: Lógica de programação – um guia completo para desenvolver carreiras em TI No material, você encontrará:fundamentos da lógica computacional;conceitos de algoritmos;estruturas básicas da programação;aplicações práticas;organização do raciocínio lógico;orientações para desenvolvimento técnico inicial. E-book: Guia linguagem de programação O conteúdo reúne:conceitos fundamentais sobre linguagens de programação;tecnologias mais utilizadas pelo mercado;diferenças entre linguagens;caminhos para especialização;passo a passo para começar na carreira de desenvolvimento. Os materiais são gratuitos e funcionam como complemento importante para quem está começando os estudos em tecnologia. FAQ – Perguntas frequentes sobre lógica de programação Lógica de programação é a capacidade de organizar instruções de maneira sequencial e coerente para que um computador execute determinada tarefa corretamente. A lógica representa o raciocínio utilizado para resolver um problema. Já o algoritmo é a sequência prática de passos criada para executar essa solução. Sim. Ter uma boa base em lógica computacional facilita muito a aprendizagem de diferentes linguagens de programação, já que os princípios de raciocínio permanecem semelhantes. A melhor forma envolve combinação entre teoria e prática. Resolver exercícios, criar pequenos projetos e consumir conteúdos especializados ajuda a desenvolver raciocínio lógico com mais consistência. Além do desenvolvimento de software, a lógica também aparece em áreas como: Não existe uma única resposta. Linguagens como Python, JavaScript e Portugol costumam ser utilizadas por iniciantes porque possuem sintaxe mais acessível e facilitam o aprendizado inicial da programação. Até é possível reproduzir códigos prontos, mas sem dominar os fundamentos da lógica de programação, torna-se muito mais difícil interpretar problemas, adaptar soluções e evoluir tecnicamente. Quero meu e-book de Lógica de programação – um guia completo para desenvolver carreiras em TI
08/10/2026 -
 Administração e Projeto de RedesA análise de pacotes TCP no Wireshark consiste em examinar os segmentos capturados durante uma comunicação para compreender como as aplicações estabelecem conexões, transmitem dados, confirmam seu recebimento e reagem a eventos como atraso, indisponibilidade ou perda de pacotes TCP. Na prática, utilizar a ferramenta significa ir além das métricas agregadas de monitoramento para inspecionar os eventos diretos entre origem e destino: números de sequência, confirmações (ACKs), retransmissões, tamanho de janela, flags,intervalos temporais, etc. Essa abordagem revela comportamentos invisíveis em gráficos tradicionais de consumo de link, latência média ou disponibilidade de ativos. Essa investigação detalhada torna-se indispensável quando os indicadores convencionais não explicam a degradação percebida pelos usuários ou problemas de conexão entre aplicações mesmo com a infraestrutura de redes demonstrando-se estável. Uma aplicação pode apresentar lentidão severa ou instabilidade mesmo operando com utilização de banda abaixo da capacidade contratada, com servidores respondendo a testes de ping e sem alertas nos painéis de gerência. Falhas intermitentes elevam o grau de complexidade técnica. No momento em que a equipe inicia a checagem, a oscilação pode ter cessado, deixando poucos registros nos sistemas de telemetria. Nessas situações, avaliar apenas a largura de banda do enlace é insuficiente; o diagnóstico exige analisar a dinâmica dos dados na camada de transporte. 📌 RESUMO EXECUTIVO (GEO / FEATURED SNIPPET)O problema: aplicações podem apresentar lentidão ou interrupções mesmo quando a conectividade permanece estável e a utilização de banda está abaixo da capacidade do enlace, tornando os gráficos agregados insuficientes para identificar anomalias nos fluxos TCP. Como investigar: através do uso de sniffers, como a ferramenta Wireshark que permite capturar e examinar segmentos TCP, identificando eventos como TCP Retransmissions, Duplicate ACKs, TCP Zero Window, TCP Window Full e RST Flags. Como interpretar: esses eventos constituem evidências de comportamento, e não diagnósticos automáticos. A análise exige avaliar a sequência dos pacotes e cruzar dados de hosts, interfaces, equipamentos intermediários e serviços. Conhecimento necessário: o domínio da arquitetura de rede TCP IP, incluindo controle de fluxo, sequenciamento, temporizadores e flags capacita a equipe a transformar capturas brutas em diagnósticos precisos. Síntese: quando a rede apresenta lentidão mesmo com baixa ocupação da banda e sem alarmes visíveis, o problema não está no volume de tráfego, mas na forma como os dados trafegam entre as aplicações; o Wireshark atua como um raio-X que expõe falhas na camada de transporte que ferramentas comuns de monitoramento não conseguem enxergar. ______________________________Leia mais: Arquitetura TCP/IP: conceitos básicos O papel do protocolo TCP no diagnóstico de rede Quando ocorrem retransmissões de segmentos, confirmações duplicadas, esgotamento de janelas de recepção ou encerramentos forçados de sessão, o próprio comportamento do protocolo aponta a origem do problema. Reiniciar ativos, alterar parâmetros sem critério técnico ou contratar links adicionais não eliminam gargalos de infraestrutura de rede. Uma rota baseada em links com capacidade de banda livre ainda pode apresentar descartes em portas de switches, filas saturadas no sistema operacional ou falhas de controle de fluxo. O diagnóstico de rede por meio do Wireshark exige a identificação de qual mecanismo da camada de transporte foi acionado para localizar o componente causador da falha. O TCP gerencia variáveis críticas da transmissão: O analisador decodifica esses cabeçalhos e organiza as conversações bidirecionais. Contudo, avisos visuais de TCP Retransmissions, Duplicate ACKs, TCP Zero Window, TCP Window Full ou falhas no handshake TCP constituem pistas técnicas, e não laudos definitivos. Cada registro deve ser avaliado conforme a linha do tempo dos pacotes, o ponto físico da captura e a topologia. O domínio da arquitetura de rede TCP IP permite interpretar esses dados brutos, formular hipóteses e corrigir a causa raiz da instabilidade. Principais anomalias no fluxo TCP passíveis de identificação no Wireshark O software captura todos os pacotes transmitidos e recebidos, estabelecendo o fluxo TCP, o que permite comparar o envio de dados, os intervalos de confirmação e as alterações de estado da conexão para identificar padrões anômalos e interpretar a lógica por trás de cada alerta evitando, assim, intervenções empíricas. Nesse contexto, as anomalias a seguir devem ser observadas. 1. Perda de pacotes e congestionamento A ocorrência de perda de segmentos compromete a eficiência da rede, forçando o protocolo a acionar os mecanismos de recuperação para retransmitir os dados não confirmados. Essa perda acarreta atrasos na entrega e indica falhas físicas ou de congestionamento no caminho entre a origem e o destino. 2. Esgotamento de buffers e gargalos no host de destino O controle de fluxo utiliza o campo Window Size para limitar o tráfego de acordo com o espaço livre no buffer do receptor. Quando o host de destino não consegue processar os dados na mesma velocidade em que são recebidos, a janela de recepção se esgota, forçando a paralisação temporária do tráfego. 3. Encerramentos abruptos de conexão O encerramento padrão de uma sessão TCP ocorre de forma ordenada por meio de troca de flags FIN. Quando a interrupção se dá por intermédio da flag RST (Reset), a conexão é abortada de imediato sem confirmação bilateral. No fluxo, essa anomalia é identificada por segmentos marcados com [RST] ou [RST, ACK]. 4. Falhas no estabelecimento de conexão (handshake initial) Antes do início da troca de dados, é necessário que a conexão do protocolo TCP seja estabelecida através do three-way handshake, mediante a troca de segmentos com as flags SYN, SYN-ACK e ACK. Anomalias nessa fase impedem a abertura do socket e geram falhas imediatas de conexão. _________________Leia mais: Práticas de privacidade e segurança de dados em TI: considerações e como fazer! Matriz de diagnóstico: alertas do Wireshark vs. infraestrutura A tabela a seguir correlaciona os alertas visuais mais comuns no Wireshark às falhas físicas e lógicas do ambiente: Alerta visual no Wireshark Comportamento do protocolo TCP Causa típica na infraestrutura TCP Retransmission Dados reenviados após a expiração do temporizador RTO por falta de confirmação (ACK). Descarte de pacotes por saturação de buffers em switches ou falha física de enlace. TCP Dup ACK Receptor solicita reenvio de segmento ausente na sequência contínua. Perda isolada de pacotes ou entrega fora de ordem por roteamento assimétrico. Spurious Retransmission Transmissor reenvia um pacote por estimativa precipitada, mas o ACK original estava apenas atrasado. Variações bruscas de latência (jitter) que descalibram o temporizador RTO. TCP Window Full Transmissor preenche 100% da capacidade do buffer de recepção anunciado pelo destino. Gargalo de I/O de disco no servidor, lentidão no processamento da aplicação ou subdimensionamento de máquinas virtuais ou contêineres. TCP Zero Window Receptor informa que seu buffer temporário está totalmente esgotado. Servidor sobrecarregado (CPU/RAM) sem processar a fila do socket de rede. Connection Reset [RST] Conexão encerrada de forma instantânea sem finalização padrão (FIN). Bloqueio por firewall, porta fechada no host ou estouro de tabela NAT. [SYN] Retransmission Reenvio cíclico do pacote inicial de conexão por causa da ausência de resposta [SYN, ACK]. Bloqueio silencioso (drop) por firewall, rota de retorno inexistente ou fila de backlog esgotada no servidor (SYN Flood). BOX SEO/GEO O que os pacotes e segmentos TCP revelam sobre o tráfego? Na pilha de protocolos, a informação enviada por uma aplicação é dividida em blocos na camada de transporte, recebendo o nome técnico de segmentos TCP. Ao descer para a camada de rede, o segmento é encapsulado dentro de um pacote IP, também denominado datagrama. Enquanto o pacote IP contém apenas as informações de endereçamento de origem e destino, o segmento TCP carrega os cabeçalhos de controle: números de sequência, confirmações de recebimento, portas lógicas e sinalizadores de estado (flags). Analisar esses dados no Wireshark significa examinar a integridade estrutural desses blocos. Cada anomalia de comunicação, seja um descarte de hardware, seja atraso de processamento, reflete diretamente nos campos de controle desses segmentos. Como estruturar a rotina prática de diagnóstico no Wireshark A investigação eficiente de falhas exige aplicar filtros de exibição focados nas sinalizações do protocolo, eliminando o ruído de pacotes irrelevantes na tela: A ferramenta fornece a visualização precisa dos dados trafegados. Contudo, a capacidade de identificar a causa raiz e definir a correção adequada depende da compreensão dos fundamentos de transporte, do roteamento e do controle de fluxo. Domínio da arquitetura de protocolos para resolução de incidentes Solucionar instabilidades complexas requer método e embasamento técnico. A dependência de tentativas empíricas eleva o tempo médio de reparo (MTTR) e expõe a infraestrutura corporativa a períodos prolongados de inatividade. O aprofundamento na arquitetura de rede tcp/ip capacita engenheiros e administradores de infraestrutura a interpretar capturas de rede com segurança técnica, isolando defeitos de cabeamento, saturação de ativos e inconsistências de configuração com precisão. CAPACITAÇÃO AVANÇADA EM INFRAESTRUTURA DE REDES Sua equipe está preparada para diagnosticar e solucionar falhas complexas na camada de transporte com precisão técnica? Aprofunde seus conhecimentos práticos sobre cabeçalhos, roteamento e controle de fluxo no curso Arquitetura e Protocolos de Rede TCP-IP da Escola Superior de Redes. ➔ ACESSAR O CURSO ARQUITETURA E PROTOCOLOS DE REDE TCP-IP NA ESR FAQ – perguntas frequetes sobre análise TCP no Wireshark 1- O que significa a cor preta com texto vermelho em pacotes no Wireshark? O esquema de cores padrão do software utiliza fundo preto e texto vermelho para sinalizar segmentos que contêm anomalias detectadas na análise do fluxo TCP, como TCP Retransmissions, TCP Duplicate ACKs, TCP Out-of-Order e Previous segment not captured. 2- A presença de pacotes de retransmissão sempre indica falha na rede local? Não. Em conexões que trafegam por links WAN ou redes de alta latência, taxas de retransmissão de até 2% podem ocorrer por causa de oscilações normais de tráfego. Em redes locais corporativas (LAN) ou data centers, a taxa esperada é próxima de zero; índices superiores a 1% indicam descarte por congestionamento em portas de switches ou atenuação física no meio de transmissão. 3- Qual filtro no Wireshark isola apenas pacotes com degradação de desempenho? O filtro tcp.analysis.flags && !tcp.analysis.window_update isola eventos de retransmissão, perda de pacotes, entregas fora de ordem e avisos de janela cheia, ocultando atualizações rotineiras de tamanho de janela. 4- Como diferenciar lentidão da aplicação de gargalos na infraestrutura de rede? Avalie o tempo decorrido entre a requisição enviada pelo cliente e o primeiro byte de dados retornado pelo servidor (Time to First Byte – TTFB). Se a etapa de estabelecimento da conexão TCP (SYN / SYN-ACK) apresentar baixa latência e ausência de retransmissões, mas o servidor demorar segundos para responder ao payload da aplicação, o gargalo localiza-se no processamento interno do software ou nas consultas a bancos de dados.
01/10/2026 -
 Ciência de Dados, SegurançaA fiscalização da ANPD avalia a capacidade real de uma organização comprovar que o tratamento de dados pessoais segue os requisitos da Lei Geral de Proteção de Dados Pessoais (Lei nº 13.709/2018), tendo a finalidade de orientar, prevenir e reprimir infrações. Além de verificar se existem termos de consentimento arquivados ou políticas institucionais publicadas na Intranet, a apuração regulatória inspeciona se essas diretrizes operam de forma contínua nos sistemas em produção, nas redes e nos bancos de dados corporativos. Para isso, a Resolução CD/ANPD nº 1/2021 determina que os agentes regulados devem fornecer informações, dados e documentos relevantes para a análise de suas atividades, além de franquear aos fiscais o acesso direto a ferramentas, ambientes tecnológicos e instalações operacionais. No âmbito da administração pública federal, essa exigência probatória ganha respaldo complementar no artigo 17 da Portaria SGD/MGI nº 9.511, que autoriza a Secretaria de Governo Digital a requisitar evidências de conformidade sobre a implementação de medidas de privacidade e segurança da informação. Essa dinâmica investigativa materializa o princípio da responsabilização e prestação de contas (accountability), previsto no artigo 6º, inciso X, da LGPD. O texto legal estabelece o dever de o agente demonstrar a adoção de medidas eficazes e capazes de comprovar a observância e o cumprimento das normas de proteção de dados pessoais. Ou seja, diante de uma notificação formal, manuais estáticos não comprovam a regularidade da operação; a autoridade exige registros verificáveis, histórico de privilégios e parâmetros técnicos capazes de demonstrar como as informações são custodiadas ao longo de todo o seu ciclo de vida. _________Síntese da preparação regulatória ANPD A preparação para a fiscalização da ANPD exige a integração contínua entre governança institucional, processos operacionais e controles de tecnologia. O escopo fiscalizatório: a autoridade investiga a consistência técnica das operações, confrontando as diretrizes escritas em manuais institucionais com as rotinas ativas na infraestrutura tecnológica. O deslocamento probatório para a TI: em um processo de auditoria, o atendimento aos requisitos regulatórios depende da capacidade das equipes de infraestrutura de extrair evidências dos sistemas, como relatórios de IAM, logs sincronizados e testes de contingência. A prontidão para incidentes: caso ocorra uma violação com risco relevante aos titulares, o prazo regulatório estipulado pela Resolução CD/ANPD nº 15/2024 é de até 3 dias úteis para comunicação oficial, exigindo contenção imediata e preservação de cadeia de custódia forense. Governança contínua: a sustentabilidade da conformidade decorre de alinhar periodicamente os instrumentos jurídicos (como RoPA e RIPD) às modificações de arquitetura, novos sistemas e parcerias com operadores. O que a ANPD pode avaliar durante uma fiscalização? O procedimento fiscalizatório instaurado pela autoridade apura a regularidade das atividades de tratamento a partir de aspectos normativos e operacionais. As diligências podem ocorrer em ciclos de monitoramento programados, denúncias formalizadas por titulares de dados ou apurações decorrentes da comunicação de incidentes de segurança. Durante o procedimento, a equipe fiscalizadora verifica elementos estruturais da operação, como: A análise desses fatores determina se a instituição mantém uma postura preventiva ou se incorre em infrações sujeitas a sanções administrativas. Por que os documentos de LGPD precisam corresponder à realidade da operação? A existência de manuais e termos de consentimento não assegura a adequação LGPD quando há divergência entre o texto aprovado e a rotina dos sistemas. Em auditorias regulatórias, declarações institucionais isoladas possuem valor probatório limitado. Um exemplo dessa desconexão ocorre na retenção de dados. Uma política corporativa pode determinar o descarte de informações cadastrais após cinco anos do término de um contrato. Se as bases de dados em produção ou os ambientes de backup mantêm esses registros por prazo indeterminado sem justificativa legal, a organização incorre em tratamento irregular. O mesmo conflito surge no controle de privilégios. Políticas que declaram a concessão de acessos restritos a funções autorizadas perdem validade quando a infraestrutura de TI mantém credenciais ativas de colaboradores desligados ou perfis administrativos compartilhados sem identificação individual. Assim, os documentos de LGPD precisam corresponder à realidade da operação, pois a autoridade confronta as informações apresentadas com os registros reais dos sistemas. Conforme orienta a visão técnica de especialistas em segurança, uma instituição não comprova conformidade porque possui uma política publicada, mas sim quando consegue relacionar cada requisito normativo às evidências produzidas pela sua infraestrutura. Sinais de despreparo operacional diante de uma notificação Se a ANPD identifica inadequações em empresas públicas ou privadas, o agente regulado fica sujeito às penalidades administrativas estabelecidas no artigo 52 da LGPD. As consequências de um procedimento sancionador variam em escala e severidade: Artigo 52, inciso I – Advertência: imposição formal com fixação de prazo determinado para a adoção de medidas corretivas;Artigo 52, inciso II – Multa simples: sanção de até 2% do faturamento da pessoa jurídica de direito privado, grupo ou conglomerado no Brasil, limitada a R$ 50 milhões por infração;Artigo 52, incisos IV a XII – Sanções operacionais e bloqueios: aplicação de multas diárias, publicização da infração, além do bloqueio temporário ou eliminação definitiva dos dados pessoais afetados, culminando na suspensão parcial ou total do exercício da atividade de tratamento. No caso das notificações preliminares, a vulnerabilidade institucional diante da fiscalização ANPD decorre de falhas estruturais de gestão que impedem o atendimento seguro e tempestivo às requisições da autoridade. Ambientes tecnologicamente imaturos costumam apresentar sintomas operacionais recorrentes: Mapear esses pontos de atenção permite reestruturar os controles internos antes que uma auditoria regulatória transforme falhas de processo em sanções pecuniárias. __________________Leia mais: O papel da governança de dados na segurança institucional Como estruturar uma rotina técnica de preparação contínua para a ANPD? Manter a instituição preparada para atender à fiscalização exige consolidar uma governança de dados que funcione de maneira contínua na operação cotidiana. Essa rotina baseia-se na execução sistemática de quatro práticas de gestão: Pilar de preparação técnica contínua ATUALIZAÇÃO DO RoPA AVALIAÇÃO PREVENTIVA (RIPD) AUDITORIAS CANAL OPERACIONAL E ATUAÇÃO DO DPO Registro dinâmico de fluxos e novas tecnologias Análise prévia de impacto e mitigação de vulnerabilidades Teste de conformidade Fluxos rastreáveis do art. 18 da LGPD A primeira medida é a manutenção dinâmica do Registro de Operações de Tratamento (RoPA). Esse inventário não pode ser um documento estático; deve ser revisado sempre que um novo sistema for incorporado, uma API for exposta ou um processo de negócio for modificado. A segunda prática envolve a elaboração antecipada do Relatório de Impacto à Proteção de Dados (RIPD) para tratamentos de alto risco ou baseados em legítimo interesse, mapeando antecipadamente as salvaguardas necessárias para mitigar exposições. Por fim, a organização deve realizar auditorias internas periódicas coordenadas entre o DPO e as lideranças técnicas. Esse diagnóstico avalia se as diretrizes de descarte seguro, retenção justificada e segregação de credenciais continuam sendo cumpridas na prática pelos times de infraestrutura e desenvolvimento de software. A quarta prática consiste na manutenção contínua do canal operacional e atuação técnica do Encarregado de Dados (DPO). Não basta publicar uma portaria de nomeação ou disponibilizar um endereço de e-mail estático no rodapé do portal institucional. A fiscalização exige comprovação de fluxos rastreáveis e integrados aos sistemas para receber, registrar e atender às solicitações dos titulares de dados – como confirmação de tratamento, acesso, retificação, bloqueio e eliminação previstos no artigo 18 da LGPD – dentro dos prazos regulatórios. Para que esse fluxo funcione sem ruídos operacionais, a equipe de tecnologia precisa manter rotinas pré-configuradas de consulta, anonimização e extração de relatórios, permitindo que o DPO responda às demandas dos titulares e às requisições da autoridade com histórico auditável de cada atendimento. ________________Leia mais: Websérie – Tudo sobre a LGPD (Lei Geral de Proteção de Dados) Como a segurança da informação sustenta a comprovação regulatória A segurança da informação na LGPD é a disciplina que transforma requisitos jurídicos em defesas auditáveis na infraestrutura corporativa. É por meio dos controles técnicos que a instituição demonstra sua diligência perante a autoridade reguladora e cumpre os requisitos que debatemos anteriormente. A sustentação das evidências apoia-se em quatro grupos de controles tecnológicos: CONTROLES TÉCNICOS DE SUSTENTAÇÃO EM TI GESTÃO DE ACESSOS (IAM) TRILHAS DE AUDITORIA (LOGS) RESILIÊNCIA CRIPTOGRAFIA & PRIVACIDADE Princípio do menor privilégio e MFA Registros sincronizados, íntegros e imutáveis Rotinas de backup, testes e descarte seguro Cifragem ponta a ponta e anonimização em homologação 1. Gestão de identidades e controle de acessos (IAM) A infraestrutura precisa demonstrar a aplicação contínua do princípio do menor privilégio. Durante as diligências, a autoridade exige relatórios de permissões vinculados estritamente às atribuições de cada cargo, registros de revogação imediata de credenciais corporativas no momento do desligamento de colaboradores e a obrigatoriedade de autenticação multifator (MFA) em contas com privilégios administrativos ou com acesso a repositórios de dados sensíveis. 2. Trilhas de auditoria e registros de eventos sincronizados Em investigações sobre acessos indevidos ou vazamentos, a equipe de tecnologia deve ser capaz de comprovar quem acessou o registro, quando a consulta ocorreu e se houve alteração ou exportação em massa de arquivos. A comprovação exige logs centralizados e sincronizados via protocolo de tempo confiável (NTP), custodiados em repositórios segregados e protegidos contra modificações por administradores locais. Sem logs íntegros, a viabilidade de defesa da instituição em uma auditoria LGPD fica comprometida. 3. Retenção, contingência e descarte seguro A custódia de dados pessoais deve limitar-se ao período justificado pela finalidade do tratamento ou por exigência legal. Para comprovar a resiliência operacional perante auditorias públicas e privadas – a exemplo das diretrizes do Guia do PPSI 2.0 para a administração federal -, a equipe de TI deve formalizar normas de backup com testes periódicos de restauração, segregação de cópias imutáveis contra ransomware e certidões técnicas que comprovem a sobrescrita lógica ou destruição física de mídias obsoletas. 4. Criptografia e privacidade desde a concepção (Privacy by Design) A integridade dos dados requer a adoção de padrões criptográficos consolidados, tanto em repouso nos bancos de dados e volumes de armazenamento quanto em trânsito por protocolos seguros de rede (como TLS 1.3). De forma complementar, os ambientes de homologação e desenvolvimento de software devem aplicar técnicas de mascaramento, pseudonimização ou anonimização, eliminando o uso de bases reais de produção em testes cotidianos. Matriz de evidências regulatórias para a TI A parametrização de controles no sistema de gestão de identidades é uma das formas eficazes para a restrição da movimentação lateral na rede, enquanto o monitoramento contínuo, logs completos, íntegros e protegidos contra alteração, retidos por prazo adequado e com relógios sincronizados entre sistemas (NTP) permite detectar incidentes e reconstituir sua cronologia. O quadro a seguir demonstra a correlação direta entre o documento institucional e as evidências de conformidade extraídas dos sistemas: Requisito Avaliado pela ANPD Objeto Normativo Declarado Evidência Técnica Auditável nos Sistemas Controle de Privilégios Política de Gestão de Acessos. Relatórios de permissões no IAM, MFA obrigatório e logs de revogação. Integridade de Dados Norma de Proteção Criptográfica. Parâmetros de TLS 1.3 ativos e certificados de criptografia de volumes em repouso. Ciclo de Vida e Descarte Tabela de Temporalidade de Dados. Rotinas automáticas de expiração de dados e certificados de sobrescrita segura. Rastreabilidade Diretriz de Monitoramento e Logs. Trilhas de log centralizadas via SIEM com carimbo de tempo sincronizado via NTP. Continuidade de Serviços Política de Backup e Contingência. Relatórios técnicos de testes de restauração e segregação de cópias imutáveis. Resumo: o que a equipe de TI precisa conseguir demonstrar quando a conformidade LGPD sai do documento e chega à infraestrutura? A transição da conformidade formal para a comprovação técnica exige que a equipe de tecnologia forneça evidências objetivas e rastreáveis aos auditores. Quando a fiscalização avança sobre o ambiente produtivo, a sustentação regulatória depende de responder diretamente a quatro questionamentos operacionais na infraestrutura: Quem acessa os dados e sob qual justificativa? Demonstrar a concessão de privilégios vinculada estritamente às funções profissionais (princípio do menor privilégio), a vigência de autenticação multifator (MFA) em contas com privilégios elevados e a revogação imediata de credenciais após o desligamento de colaboradores; Onde as informações residem e como são protegidas? Comprovar a localização exata de cada banco de dados, servidor ou repositório em nuvem, atestando a presença de criptografia ativa em repouso e em trânsito, além do isolamento de ambientes de desenvolvimento por meio de mascaramento ou anonimização; Qual é a rastreabilidade dos eventos? apresentar trilhas de auditoria (logs) centralizadas, sincronizadas via protocolo de tempo confiável (NTP) e protegidas contra adulteração, capazes de reconstituir quem visualizou, editou ou exportou registros pessoais; Como ocorre a retenção, a contingência e o descarte? Comprovar que os prazos de custódia estabelecidos no inventário são executados por rotinas automáticas de expiração ou descarte seguro, sustentadas por planos de backup periódicos com testes documentados de restauração e proteção contra incidentes cibernéticos. A consolidação dessas quatro respostas técnicas assegura que a governança de privacidade não permaneça restrita a declarações em manuais, fornecendo a base material exigida para atender à fiscalização com segurança institucional. Contudo, manter esses controles em operação contínua é apenas a primeira metade do desafio. A verdadeira prova de maturidade da infraestrutura ocorre quando os mecanismos preventivos falham e o ambiente enfrenta uma crise em tempo real. O teste definitivo da governança: resposta técnica a incidentes críticos Conforme enfatizam os especialistas e instrutores das trilhas de Segurança da Informação e Cibersegurança da Escola Superior de Redes (ESR), nenhum ambiente tecnológico é completamente imune a falhas ou intrusões. Em auditorias e investigações da autoridade, o diferencial entre uma infraestrutura considerada diligente e uma organização passível de sanção severa não reside na promessa inalcançável de risco zero, mas na capacidade técnica de conter o incidente de forma tempestiva, limitar a exposição e apresentar registros forenses íntegros. É no momento da crise que a teoria jurídica é posta à prova perante a engenharia de sistemas. Caso ocorra uma violação, a legislação e as normas infralegais não exigem que todo incidente de segurança seja compulsoriamente reportado à autoridade; a obrigatoriedade de comunicação formal restringe-se aos episódios capazes de gerar risco ou dano relevante aos direitos e liberdades fundamentais dos titulares. A avaliação do risco ou dano relevante segue o art. 5º da Resolução CD/ANPD nº 15/2024. O incidente deve ser comunicado quando puder afetar significativamente interesses e direitos fundamentais dos titulares (por exemplo, impedindo o exercício de direitos ou o uso de serviços, ou ocasionando danos materiais ou morais como discriminação, fraudes financeiras ou roubo de identidade) e, cumulativamente, envolver ao menos um dos seguintes elementos: Na apreciação da gravidade, a ANPD considera ainda, nos termos do art. 48, §3º, da LGPD, se foram adotadas medidas técnicas adequadas que tornem os dados ininteligíveis para terceiros não autorizados, como criptografia com gestão segura de chaves, devidamente documentadas. Constatada a relevância do evento, a Resolução CD/ANPD nº 15/2024 determina o prazo regulatório de até 3 dias úteis para a comunicação oficial à ANPD, contados a partir da ciência inequívoca da ocorrência. Esse intervalo extremamente exíguo impede qualquer improvisação. A equipe de tecnologia precisa ter procedimentos previamente homologados para isolar o perímetro atingido, estancar a exfiltração de dados e preservar a cadeia de custódia das evidências forenses (logs de borda, imagens de memória e registros de conexão). São justamente esses artefatos técnicos que subsidiarão o Encarregado de Dados (DPO) na elaboração do relatório oficial à ANPD, demonstrando que a organização agiu com a prontidão e o rigor que a legislação exige. Nem todo incidente de segurança deve ser notificado à ANPDA comunicação formal à autoridade e aos titulares só é juridicamente obrigatória quando a violação de dados envolver risco ou dano relevante aos direitos e liberdades individuais (art. 48 da LGPD c/c Resolução CD/ANPD nº 15/2024).O critério do dano relevante: incidentes que afetem apenas a confidencialidade de dados já públicos, ou eventos estritamente internos sem exfiltração, sem indisponibilidade de serviços essenciais e sem exposição de categorias sensíveis, dispensam a notificação à autoridade reguladora. O papel das salvaguardas técnicas: se bases de dados vazadas estiverem protegidas por cifragem com padrões de ponta (como algoritmos com chaves íntegras sob custódia segura), o incidente pode ser classificado como mitigado na origem, reduzindo ou afastando a obrigação de comunicação aos titulares. Dever de registro interno (Accountability): mesmo que o evento não atinja o limiar de notificação à ANPD, a organização deve registrar a ocorrência no seu Livro ou Registro Interno de Incidentes, documentando a análise de risco, a justificativa técnica para o não envio da notificação e as medidas de remediação implementadas. Estruture seu plano de prontidão técnica Compreender as exigências regulatórias e identificar os parâmetros avaliados pelos fiscais da Autoridade Nacional de Proteção de Dados é a base necessária para proteger a instituição. No entanto, transferir esses conceitos jurídicos e de arquitetura para a rotina diária dos servidores, bancos de dados e esteiras de desenvolvimento demanda um roteiro prático e acionável. Enquanto este artigo estabelece os fundamentos normativos, os critérios de auditoria e a lógica de sustentação probatória da TI, o “Auditoria LGPD: guia prático para demonstrar conformidade antes da fiscalização” funciona como a ferramenta de campo para a sua equipe. Nele, você encontra o passo a passo para transformar políticas em verificações operacionais, incluindo modelos de checklist para validação de controles de acesso (IAM), templates para estruturação do inventário de dados (RoPA) e métodos para auditar a integridade das suas trilhas de log antes que uma notificação oficial chegue. Faça o download do e-book gratuito e antecipe-se às exigências regulatórias, assegurando que a sua governança de privacidade seja sustentada por evidências sólidas e auditáveis: GUIA TÉCNICO LGPDSua infraestrutura de TI está preparada para comprovar diligência diante de uma intimação formal da ANPD?BAIXAR GUIA PRÁTICO DE CONFORMIDADE LGPD GRATUITAMENTE Perguntas Frequentes sobre Fiscalização da ANPD Quais sanções a ANPD pode aplicar em caso de irregularidades? O artigo 52 da LGPD estabelece sanções administrativas que variam desde advertências formais com prazo para correção até multas simples de até 2% do faturamento da pessoa jurídica (limitadas a R$ 50 milhões por infração), multas diárias, bloqueio temporário ou eliminação definitiva dos dados envolvidos, além da suspensão parcial do funcionamento do banco de dados afetado. A ANPD avisa com antecedência sobre uma fiscalização? Nos procedimentos de fiscalização programados e nos pedidos formais de esclarecimento, a autoridade expede notificação oficial com prazo estipulado para que o agente envie as manifestações e documentos requeridos. Contudo, em apurações de emergência decorrentes de incidentes cibernéticos ou denúncias de grande repercussão, as solicitações podem exigir respostas imediatas com envio de registros operacionais. A existência de uma Política de Segurança da Informação afasta penalidades? Não. A existência formal da política comprova apenas o compromisso normativo da organização. Se a autoridade constatar que as regras descritas no documento não encontram respaldo na configuração técnica dos servidores, na concessão de privilégios ou nas rotinas de segurança de TI, a organização poderá ser autuada por infração ao princípio da responsabilização. Qual o papel do Encarregado de Dados (DPO) durante a fiscalização? O DPO atua como o canal oficial de comunicação entre a organização e a autoridade fiscalizadora. Durante a apuração, cabe a esse profissional articular as respostas institucionais em conjunto com as lideranças de infraestrutura de TI, segurança da informação, jurídico e alta administração para consolidar as evidências requeridas.
24/09/2026